
Chuyên đề 8: Python khi đi thi: viết sao cho đủ nhanh, đọc ghi nhanh, hàm có sẵn, đệ quy sâu và khi nào nên chuyển sang C++
Lời mở đầu
Ở bài 1, mình đã đo một vòng lặp $10^8$ lần: C++ chạy khoảng 0,1 giây, Python mất cỡ 8 giây. Nhiều bạn đọc tới đó liền kết luận “thi thì phải dùng C++”. Thực tế không đơn giản như vậy: rất nhiều đề HSG cấp tỉnh, đề chuyên Tin có giới hạn vừa phải, và một bài Python viết đúng cách vẫn đạt trọn điểm. Ngược lại, một bài Python viết “kiểu C++” (đọc từng dòng bằng input(), in từng số bằng print, tìm kiếm bằng list.index) có thể chậm hơn bản viết đúng tới cả trăm lần.
Chuyên đề cuối cùng này là “sổ tay đi thi” cho bạn nào chọn Python. Mình giả sử em đã nắm cách ước lượng độ phức tạp ở bài 9, biết các cấu trúc dữ liệu ở bài 11: STL cơ bản và đã đọc phần đọc ghi file ở chuyên đề 7. Mọi đoạn code vẫn có cả C++ lẫn Python để em thấy cách viết tương đương; các bảng thời gian đều do thầy đo thật trên máy mình (Python 3.13, g++ -O2), con số trên máy chấm sẽ khác đôi chút nhưng tỉ lệ giữa các cách viết thì gần như giữ nguyên.
main(); đọc nhanh bằng sys.stdin.buffer.read().split(), in nhanh bằng join; dùng các hàm có sẵn chạy bằng C: sum, sorted, min/max với key, Counter, bisect, itertools, set/dict tra cứu $O(1)$; đệ quy sâu với setrecursionlimit, luồng có ngăn xếp lớn và cách khử đệ quy bằng ngăn xếp tự quản; các bẫy và mẹo hay gặp: mảng 2 chiều, heapq, deque, số nguyên lớn; và bảng khi nào nên dùng C++. Có 2 khung chạy tay, 3 mô phỏng bấm từng bước và 8 bài tập kèm gợi ý.Lộ trình bài viết, bấm vào từng phần để nhảy tới:
Phần 1Vì sao Python chậm và làm sao biết bài có kịp không?
Chương trình C++ được biên dịch một lần ra mã máy, rồi CPU chạy thẳng mã đó. Python thì khác: mã nguồn được dịch ra bytecode (các lệnh trung gian), và mỗi lần chạy, trình thông dịch phải đọc từng lệnh bytecode, xem đó là lệnh gì, kiểm tra kiểu dữ liệu rồi mới thực hiện. Thêm nữa, mỗi số nguyên trong Python là một đối tượng nằm trong bộ nhớ, nên phép s += x không chỉ là một phép cộng mà còn tạo đối tượng mới, cập nhật bộ đếm tham chiếu… Hình dưới so sánh một vòng của vòng lặp cộng dồn:
Hình 1. Một vòng for x in a: s += x. Bên phải là bytecode thật mà Python 3.13 sinh ra (xem bằng import dis; dis.dis(f)).
Từ đó ta có quy tắc ước lượng cho người dùng Python, đặt cạnh quy tắc $10^8$ phép mỗi giây của C++ mà em đã học ở bài 9:
sum, sorted, x in set, split, join…) thì nhanh gần bằng C++. Vậy khi đọc đề, em đếm số vòng lặp Python chứ không chỉ đếm độ phức tạp.| Đoạn code | Số vòng | C++ | Python |
|---|---|---|---|
s += i * i % 7 | $10^7$ | 0,015 s | 0,71 s |
s += i * i % 7 | $10^8$ | 0,13 s | 7,3 s |
s += i viết thẳng ngoài hàm (biến toàn cục) | $10^7$ | – | 0,66 s |
s += i viết trong def main() | $10^7$ | – | 0,31 s |
s = sum(range(n)) | $10^7$ | – | 0,17 s |
s = n * (n - 1) // 2 (công thức) | 1 | – | ≈ 0 s |
Bảng 1. Thời gian đo trên máy của thầy (Python 3.13, g++ -O2), chỉ mang tính tương đối. Dòng cuối nhắc em: tìm được công thức hay thuật toán tốt hơn luôn là cách tăng tốc mạnh nhất.
Hai dòng giữa cho thấy một mẹo miễn phí: chỉ cần bọc code vào một hàm là nhanh gần gấp đôi. Lý do: biến toàn cục được tìm trong một từ điển tên, còn biến cục bộ của hàm được Python đánh số sẵn và truy cập theo chỉ số. Vì vậy mọi code Python trong chuyên đề này đều viết trong hàm main():
Xem code C++ / Python: tổng i * i % 7 viết trong hàm main (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    long long n;
    cin >> n;
    long long s = 0;
    for(long long i = 1; i <= n; i++) s += i * i % 7;
    cout << s;
    return 0;
}
import sys
def main(): # đặt code trong hàm: biến cục bộ nhanh gần gấp đôi
n = int(sys.stdin.readline())
s = 0
for i in range(1, n + 1):
s += i * i % 7
print(s)
main()Đọc giới hạn để biết Python có kịp không. Ghép quy tắc trên với độ phức tạp của thuật toán, em được bảng tra nhanh dưới đây cho giới hạn 1 giây. Cột Python giả sử phần nặng nhất là vòng lặp tự viết; nếu phần nặng nhất là sorted hay thao tác trên set, Python gần theo kịp cột C++. Cách đọc giới hạn để đoán thuật toán em xem thêm ở bài 22: Kỹ năng luyện thi.
| Độ phức tạp | C++ (~$10^8$ phép/s) | Python vòng lặp thuần (~$10^7$/s) | Ghi chú cho Python |
|---|---|---|---|
| $O(n)$ | $n \le 10^8$ | $n \le 10^7$ | với $n = 10^6$ thoải mái nếu đọc nhanh |
| $O(n \log n)$ | $n \le 5 \cdot 10^6$ | $n \le 5 \cdot 10^5$ | sorted $10^6$ số mất khoảng 0,33 s |
| $O(n \sqrt n)$ | $n \le 2 \cdot 10^5$ | $n \le 4 \cdot 10^4$ | thường phải tối ưu kỹ |
| $O(n^2)$ | $n \le 10^4$ | $n \le 3000$ | $n = 5000$: 2,5 giây, quá giờ |
| $O(n^3)$ | $n \le 450$ | $n \le 200$ | Floyd, QHĐ đoạn: cân nhắc C++ |
| $O(2^n)$ | $n \le 26$ | $n \le 22$ | quay lui: Python chậm hơn nhiều |
Bảng 2. Giới hạn $n$ ước lượng để chạy trong 1 giây. Đây là con số để định hướng, không phải luật cứng: hằng số trong thân vòng lặp có thể làm lệch 2–3 lần.
Phần 2Đọc, ghi nhanh: sys.stdin.buffer, map và join
Với dữ liệu lớn, đọc và in thường chiếm phần lớn thời gian chạy của bài Python. Nguyên nhân là input() và print() làm rất nhiều việc phụ mỗi lần gọi (tìm luồng, xử lý mã hoá, bỏ dấu xuống dòng, đổi số ra xâu, kiểm tra tham số sep, end…). Gọi một triệu lần là một triệu lần làm việc phụ đó. Phần C++ (ios::sync_with_stdio(false), '\n' thay cho endl) em đã học ở bài 9 và chuyên đề 7; ở đây mình đo cho rõ và tập trung vào Python.
| Cách làm (10⁶ số, mỗi số một dòng) | Thời gian | Nhận xét |
|---|---|---|
int(input()) trong vòng lặp | 0,75 – 0,83 s | cách “mặc định”, chậm nhất |
input = sys.stdin.readline rồi int(input()) | 0,22 s | nhanh gấp gần 4 lần, đổi đúng một dòng |
sys.stdin.buffer.read().split() + map(int, …) | 0,17 s | đọc hết một lần, nhanh nhất |
C++: cin chưa tắt đồng bộ | 0,32 s | C++ viết vụng còn chậm hơn Python viết khéo! |
C++: cin sau ios::sync_with_stdio(false) | 0,07 s | |
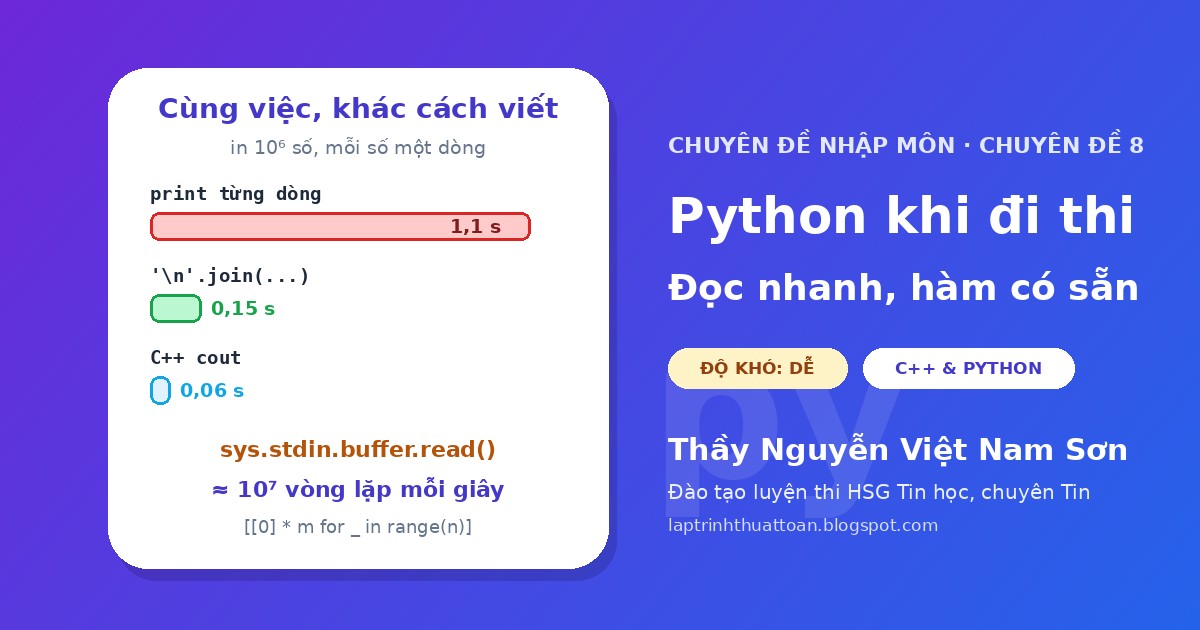
print(x) từng dòng (in 10⁶ số) | 1,1 – 1,6 s | chậm nhất trong cả bảng |
sys.stdout.write('\n'.join(map(str, a))) | 0,15 s | ghép một lần, in một lần |
C++: cout << x << '\n' / endl | 0,06 s / 0,5 s | endl xả bộ đệm mỗi dòng |
Bảng 3. Đọc và in $10^6$ số (đo trên máy thầy, chỉ để so sánh tương đối). Đọc kiểu nào cũng được khi $n \le 10^4$; khi $n$ cỡ $10^5$ trở lên thì cách đọc bắt đầu quyết định điểm số.
Đọc hết một lần rồi tách. sys.stdin.buffer.read() lấy toàn bộ dữ liệu vào dưới dạng bytes chỉ với một lần gọi, .split() tách theo mọi khoảng trắng (dấu cách, tab, xuống dòng) bằng mã C, cho ra list các mẩu bytes. Hàm int() nhận thẳng được bytes nên không cần đổi sang xâu. Ưu điểm phụ: em không phải quan tâm dữ liệu nằm trên mấy dòng, đề có xuống dòng lung tung cũng không sao.
Hình 2. Quy trình đọc nhanh. Mọi mẩu dữ liệu nằm sẵn trong list, em lấy dần theo chỉ số hoặc bằng một con trỏ.
import sys

def main():
    data = sys.stdin.buffer.read().split()
    it = iter(data)                  # con trỏ đọc lần lượt
    n = int(next(it))
    a = [int(next(it)) for _ in range(n)]
    # ... hoặc cắt lát: a = list(map(int, data[1:n + 1]))
    out = []
    for x in a:
        out.append(x * 2)            # gom kết quả vào list
    sys.stdout.write('\n'.join(map(str, out)) + '\n')

main()main(), gom kết quả rồi in một lần.Ví dụ. Đề cho $n$ học sinh, mỗi dòng gồm tên (không có dấu cách) và điểm. In tên các bạn có điểm từ 5 trở lên theo thứ tự đầu vào, mỗi tên một dòng; không có ai thì in KHONG CO. Chú ý: tên đọc từ buffer là bytes (b'An'), phải .decode() trước khi ghép với xâu thường.
Xem code C++ / Python: đọc nhanh tên và điểm, in một lần bằng join (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);   // tăng tốc cin/cout
    int n;
    cin >> n;
    vector<string> res;
    for(int i = 0; i < n; i++){
        string name;
        int d;
        cin >> name >> d;
        if(d >= 5) res.push_back(name);
    }
    if(res.empty()) cout << "KHONG CO\n";
    for(auto &s : res) cout << s << '\n';             // '\n' thay cho endl
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split() # đọc HẾT một lần, tách theo dấu cách và xuống dòng
n = int(data[0])
res = []
for i in range(n):
name = data[1 + 2 * i] # kiểu bytes, ví dụ b'An'
d = int(data[2 + 2 * i]) # int() nhận được cả bytes
if d >= 5:
res.append(name.decode()) # đổi bytes -> str trước khi in
if not res:
res.append('KHONG CO')
sys.stdout.write('\n'.join(res) + '\n') # ghép rồi in MỘT lần
main()sys.stdin.readline() giữ lại ký tự '\n' ở cuối. Đọc số thì int() tự bỏ qua, nhưng đọc xâu thì phải .rstrip() (hoặc .strip()), nếu không xâu bị dài thêm 1 và so sánh sai.2. Đọc từ
buffer được bytes: b'abc' == 'abc' là False. Hoặc so sánh bytes với bytes, hoặc .decode() trước.3. Đề có dòng chứa dấu cách (họ tên đầy đủ, câu văn) thì không dùng
split() toàn bộ được, vì nó tách cả dấu cách trong dòng. Khi đó đọc theo dòng: lines = sys.stdin.buffer.read().decode().split('\n').Phần 3Dùng hàm có sẵn chạy bằng C, chọn đúng cấu trúc dữ liệu
Nguyên tắc vàng của Python: đẩy vòng lặp vào bên trong hàm có sẵn. Khi em gọi sum(a), vòng lặp cộng chạy trong mã C của Python, không phải thông dịch từng lệnh. Nhưng còn quan trọng hơn: nhiều thao tác trông “vô hại” lại ẩn một vòng lặp $O(n)$ bên trong, đặt nó vào vòng lặp ngoài là thành $O(n^2)$:
x in a,a.index(x),a.count(x),a.remove(x)vớialà list: duyệt cả list, $O(n)$. Vớiset/dict: $O(1)$.a.pop(0),a.insert(0, x): dồn cả list, $O(n)$. Dùngcollections.dequeđể thêm, bớt ở đầu trong $O(1)$.s = s + ttrong vòng lặp với xâu: mỗi lần tạo xâu mới và chép lại phần cũ. Gom vào list rồi''.join(...).a[l:r](cắt lát) tạo list mới, tốn $O(r - l)$. Cắt lát trong vòng lặp lớn cũng là $O(n^2)$.
Mô phỏng dưới đây “đua” các cách viết cho cùng một việc. Em đổi việc cần làm và đổi $n$ để thấy cách nào đỏ trước:
| Việc cần làm | Cách chậm | Thời gian | Cách nhanh | Thời gian |
|---|---|---|---|---|
| $10^4$ câu hỏi “có trong dãy $10^4$ số?” | x in a (list) | 0,39 s | x in s (set) | 0,0003 s |
| Lấy đầu hàng $10^5$ lần | a.pop(0) | 0,94 s | dq.popleft() | 0,005 s |
| Ghép $10^5$ ký tự | s = s + c (*) | 0,14 s | ''.join(parts) | 0,004 s |
| Đếm tần suất $10^6$ số | vòng for + dict | 0,10 – 0,14 s | Counter(a) | 0,07 – 0,09 s |
| Tìm max của $10^6$ số | vòng for + if | 0,018 s | max(a) | 0,009 s |
| Tạo list $10^6$ phần tử | vòng for + append | 0,049 s | list comprehension | 0,042 s |
Bảng 4. Đo trên máy thầy. Ba dòng đầu là đổi độ phức tạp (nhanh hơn hàng trăm lần), ba dòng sau chỉ đổi hằng số (nhanh hơn 1–2 lần). (*) CPython có tối ưu riêng cho s += c khi không biến nào khác cùng giữ xâu s, nhưng điều đó không được đảm bảo (PyPy, hay chỉ cần thêm một biến tham chiếu là mất), nên đừng dựa vào nó.
Ví dụ: đếm cặp có tổng bằng $x$. Cho dãy $n$ số và số $x$, đếm số cặp $i < j$ có $a_i + a_j = x$. Hai vòng for là $O(n^2)$: với $n = 2 \cdot 10^5$ thì C++ còn chật vật, Python thì không có cửa. Cách tốt: duyệt $j$ từ trái sang phải, giữ một bảng đếm cnt các số đã gặp. Số $a_j$ ghép được với mọi số bên trái có giá trị $x - a_j$, mà số lượng của chúng chính là cnt[x - a_j], tra trong $O(1)$. Cùng ý tưởng này em đã gặp ở bài 13: mảng đánh dấu, chỉ khác là giá trị có thể rất lớn hoặc âm nên ta dùng dict thay cho mảng.
Xem code C++ / Python: đếm cặp có tổng bằng x bằng map / dict (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    long long x;
    cin >> n >> x;
    map<long long, int> cnt;           // cnt[v] = số lần v đã gặp ở bên trái
    long long ans = 0;
    for(int j = 0; j < n; j++){
        long long a;
        cin >> a;
        auto it = cnt.find(x - a);     // ghép a với mọi số bên trái bằng x - a
        if(it != cnt.end()) ans += it->second;
        cnt[a]++;
    }
    cout << ans;
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split()
n, x = int(data[0]), int(data[1])
cnt = {} # cnt[v] = số lần v đã gặp ở bên trái
ans = 0
for a in map(int, data[2:2 + n]):
ans += cnt.get(x - a, 0) # tra dict: O(1), không duyệt lại dãy
cnt[a] = cnt.get(a, 0) + 1
print(ans)
main()Bảng dưới là “từ điển dịch” các hàm có sẵn em hay dùng nhất, kèm bản tương đương trong C++ (nhớ lại bài 11 và bài 10). Thuộc bảng này là em đã có gần đủ “vũ khí” cho các bài nhập môn bằng Python.
| Việc | Python | C++ tương đương | Độ phức tạp |
|---|---|---|---|
| Tổng, min, max | sum(a), min(a), max(a) | accumulate, *min_element, *max_element | $O(n)$ |
| Vị trí của số lớn nhất | max(range(n), key=a.__getitem__) | max_element(a, a + n) - a | $O(n)$ |
| Sắp xếp nhiều tiêu chí | sorted(a, key=lambda t: (-t[1], t[0])) | sort với hàm cmp | $O(n \log n)$ |
| Đếm tần suất | Counter(a), c.most_common(k) | map<int, int> cnt | $O(n)$ |
| Tìm kiếm nhị phân | bisect_left, bisect_right | lower_bound, upper_bound | $O(\log n)$ |
| Mảng cộng dồn | list(accumulate(a)) | partial_sum | $O(n)$ |
| Duyệt tổ hợp, hoán vị | combinations(a, k), permutations(a) | next_permutation | theo số cấu hình |
| Tập hợp, từ điển | set, dict (bảng băm) | unordered_set, unordered_map | $O(1)$ trung bình |
| Đảo ngược, ghép xâu | a[::-1], ' '.join(...) | reverse, vòng cout | $O(n)$ |
Bảng 5. Hàm có sẵn trong Python và bản tương đương C++. Counter ở collections; bisect_left, bisect_right ở bisect; accumulate, combinations, permutations ở itertools.
min, max, sorted đều nhận tham số key: hàm biến mỗi phần tử thành “giá trị để so sánh”. Muốn sắp giảm dần theo điểm nhưng tăng dần theo tên, dùng key là bộ (-diem, ten): bộ được so sánh lần lượt từng thành phần, và đổi dấu giúp đảo chiều một tiêu chí số. Với tiêu chí là xâu không đổi dấu được thì sắp 2 lần (sắp theo tiêu chí phụ trước, rồi tiêu chí chính sau), vì sorted của Python là sắp xếp ổn định.Phần 4Đệ quy sâu: setrecursionlimit, luồng có ngăn xếp lớn và ngăn xếp tự quản
Ở bài 5 em đã viết đệ quy tính $n!$. Mỗi lời gọi hàm chưa xong được cất vào ngăn xếp lời gọi (call stack) để chờ lời gọi con trả về. Python chặn độ sâu này ở 1000 tầng theo mặc định: gọi sâu hơn là nhận ngay RecursionError: maximum recursion depth exceeded. Bài Python dùng đệ quy (DFS, quay lui, đệ quy có nhớ) với dữ liệu kiểu “chuỗi dài” $10^5$ phần tử sẽ chết ngay ở test lớn, dù thuật toán hoàn toàn đúng.
Bài toán mẫu: cấp bậc trong công ty. Có $n$ người, người $i$ có sếp trực tiếp là $p_i$ ($p_i = 0$ nghĩa là giám đốc, cấp 1). Cấp của một người bằng cấp của sếp cộng 1. In cấp của mọi người. Công thức đệ quy rất tự nhiên: level(u) = level(p[u]) + 1, có nhớ lại kết quả để mỗi người chỉ tính một lần. Nhưng nếu công ty là một “chuỗi” $1 \to 2 \to \ldots \to n$ thì đệ quy sâu đúng $n$ tầng.
Cách 1: nâng giới hạn. sys.setrecursionlimit(10**6) bỏ chốt chặn 1000 tầng. Tuy vậy, với Python 3.10 trở về trước (nhiều máy chấm vẫn dùng), mỗi tầng đệ quy Python còn chiếm cả ngăn xếp của C (mặc định chỉ vài MB), nên đệ quy quá sâu sẽ làm chương trình chết hẳn (Segmentation fault, máy chấm báo RE) thay vì báo lỗi. Cách chữa là chạy hàm chính trong một luồng (thread) mới được cấp ngăn xếp lớn. Từ Python 3.11, lời gọi giữa các hàm Python không còn ăn ngăn xếp C nên chỉ cần setrecursionlimit, nhưng khuôn mẫu dưới đây chạy được trên mọi phiên bản:
Xem code C++ / Python: đệ quy có nhớ với setrecursionlimit và threading (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int n, p[200005], lv[200005];

int level(int u){
    if(lv[u]) return lv[u];                // đã tính rồi thì dùng lại
    if(p[u] == 0) return lv[u] = 1;        // giám đốc: cấp 1
    return lv[u] = level(p[u]) + 1;        // cấp của sếp + 1
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    cin >> n;
    for(int i = 1; i <= n; i++) cin >> p[i];
    for(int i = 1; i <= n; i++) level(i);
    for(int i = 1; i <= n; i++) cout << lv[i] << " ";
    return 0;
}
import sys, threading
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
p = [0] + [int(x) for x in data[1:n + 1]]
lv = [0] * (n + 1)
def level(u):
if lv[u]: # đã tính rồi thì dùng lại
return lv[u]
lv[u] = 1 if p[u] == 0 else level(p[u]) + 1
return lv[u]
for i in range(1, n + 1):
level(i)
sys.stdout.write(' '.join(map(str, lv[1:])) + '\n')
sys.setrecursionlimit(1 << 25) # bỏ giới hạn 1000 tầng của Python
threading.stack_size(1 << 26) # xin 64 MB ngăn xếp cho luồng mới
t = threading.Thread(target=main)
t.start()
t.join()Cách 2: ngăn xếp tự quản. Ý tưởng: thứ mà đệ quy cất lên ngăn xếp lời gọi chính là “những người đang chờ biết cấp của sếp”. Ta tự cất họ vào một list bình thường st: từ người $i$, đi lên theo $p$ và đẩy từng người chưa biết cấp vào st, tới khi gặp người đã biết cấp (hoặc đi quá giám đốc). Sau đó lấy dần từ đỉnh st ra: người lấy ra trước là người được đẩy vào sau cùng, tức là người gần giám đốc nhất, nên sếp của họ chắc chắn đã có cấp. List có thể dài $10^6$ phần tử mà không cần giới hạn nào cả.
Em so sánh hai cách trong mô phỏng: chọn “Đệ quy có nhớ” rồi “Ngăn xếp tự quản”, để ý chiều cao ngăn xếp ở hai bên luôn giống nhau, chỉ khác ai giữ nó:
Xem code C++ / Python: tính cấp bậc bằng ngăn xếp tự quản (không đệ quy) (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int n, p[200005], lv[200005];

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    cin >> n;
    for(int i = 1; i <= n; i++) cin >> p[i];
    vector<int> st;                                   // ngăn xếp tự quản
    for(int i = 1; i <= n; i++){
        int u = i;
        while(u != 0 && lv[u] == 0){                  // đi lên, cất những người chưa biết cấp
            st.push_back(u);
            u = p[u];
        }
        while(!st.empty()){                           // lấy ra theo thứ tự ngược lại
            int v = st.back(); st.pop_back();
            lv[v] = (p[v] == 0) ? 1 : lv[p[v]] + 1;   // sếp của v chắc chắn đã có cấp
        }
    }
    for(int i = 1; i <= n; i++) cout << lv[i] << " ";
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
p = [0] + [int(x) for x in data[1:n + 1]]
lv = [0] * (n + 1)
st = [] # ngăn xếp tự quản: list bình thường
for i in range(1, n + 1):
u = i
while u != 0 and lv[u] == 0: # đi lên, cất những người chưa biết cấp
st.append(u)
u = p[u]
while st: # lấy ra theo thứ tự ngược lại
v = st.pop()
lv[v] = 1 if p[v] == 0 else lv[p[v]] + 1
sys.stdout.write(' '.join(map(str, lv[1:])) + '\n')
main()for i in range(1, n + 1): lv[i] = lv[p[i]] + 1. Đây chính là tư tưởng của quy hoạch động ở bài 19: tính từ bài toán nhỏ lên.2. Ngăn xếp tự quản như trên: đẩy những việc “đang chờ” vào list, xử lý khi điều kiện đã đủ.
3. Mô phỏng ngăn xếp lời gọi: mỗi phần tử của
st lưu cả trạng thái lời gọi (đang xét tới con thứ mấy…). Cách này dùng cho DFS trên đồ thị, em sẽ gặp lại ở bài 21.Phần 5Mẹo hay dùng, bẫy kinh điển và khi nào nên chuyển sang C++
Mảng 2 chiều đúng cách. Trong C++ em khai báo int a[1005][1005]; là xong. Trong Python, cách “ngắn gọn” a = [[0] * m] * n là một cái bẫy: phép * n không tạo ra $n$ hàng mới mà tạo $n$ mũi tên cùng trỏ vào một hàng. Gán a[1][2] = 7 thì cả cột 2 của mọi hàng đều thành 7! Cách đúng là a = [[0] * m for _ in range(n)]: biểu thức [0] * m được tính lại ở mỗi lượt nên mỗi hàng là một list riêng. Em xem tận mắt bằng mô phỏng hình hộp và mũi tên:
* trên list luôn nhân bản tham chiếu. Với [0] * m, các ô cùng trỏ vào số 0, nhưng số nguyên không sửa được tại chỗ: gán a[j] = 5 chỉ đổi mũi tên của ô $j$ sang số 5, các ô khác không ảnh hưởng. Còn list thì sửa được tại chỗ, nên nhân bản tham chiếu tới list là nguy hiểm. Cùng lý do, b = a không sao chép list: muốn sao chép một hàng dùng a[:], sao chép bảng 2 chiều dùng [row[:] for row in a].Truy cập mảng 2 chiều nhanh hơn. Mỗi lần viết a[i][j] Python phải tra hai lần. Trong vòng lặp lồng nhau, lấy sẵn hàng ra một biến (row = a[i], rồi dùng row[j]) bớt được một nửa số lần tra. Thầy đo việc điền bảng $1000 \times 1000$: khoảng 0,05 giây khi dùng biến row. Điều này rất có ích ở các bài lưới như chuyên đề 4.
Hàng đợi ưu tiên với heapq. Python không có lớp priority_queue mà có module heapq thao tác trên một list thường: heapify(h), heappush(h, x), heappop(h), phần tử nhỏ nhất luôn ở h[0]. Ngược với C++ (mặc định priority_queue lấy số lớn nhất). Muốn lấy số lớn nhất trong Python, đẩy vào -x rồi đổi dấu khi lấy ra. Phần tử có thể là bộ (khoá, giá trị), so sánh theo khoá trước. Ví dụ kinh điển gộp sỏi: có $n$ đống sỏi, mỗi lần gộp hai đống tốn chi phí bằng tổng hai đống; luôn gộp hai đống nhỏ nhất thì tổng chi phí nhỏ nhất.
Xem code C++ / Python: gộp sỏi bằng hàng đợi ưu tiên heapq / priority_queue (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    priority_queue<long long, vector<long long>, greater<long long>> pq;   // đỉnh là số NHỎ nhất
    for(int i = 0; i < n; i++){ long long x; cin >> x; pq.push(x); }
    long long cost = 0;
    while(pq.size() > 1){
        long long a = pq.top(); pq.pop();
        long long b = pq.top(); pq.pop();
        cost += a + b;                 // gộp hai đống nhỏ nhất
        pq.push(a + b);
    }
    cout << cost;
    return 0;
}
import sys
from heapq import heapify, heappop, heappush
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
h = list(map(int, data[1:n + 1]))
heapify(h) # biến list thành đống trong O(n); h[0] là số NHỎ nhất
cost = 0
while len(h) > 1:
a = heappop(h)
b = heappop(h)
cost += a + b # gộp hai đống nhỏ nhất
heappush(h, a + b)
print(cost)
main()deque cho hàng đợi. from collections import deque: append, appendleft, pop, popleft đều $O(1)$. Đừng dùng list.pop(0) làm hàng đợi (Bảng 4: chậm gấp gần 200 lần). Và số nguyên lớn là lợi thế lớn nhất của Python: không bao giờ tràn số, pow(a, b, m) tính lũy thừa modulo, math.isqrt(n) lấy căn nguyên chính xác (tránh lỗi làm tròn của int(n ** 0.5)), math.gcd, math.comb có sẵn. Những bài “số siêu lớn” ở chuyên đề 3 viết bằng Python chỉ vài dòng.
Vậy khi nào nên chuyển sang C++? Bảng dưới là kinh nghiệm thầy rút ra sau nhiều mùa thi. Ý chính: Python mạnh khi phần nặng nằm trong hàm có sẵn hoặc trong số học số lớn; C++ cần thiết khi phần nặng là vòng lặp tự viết với hàng chục triệu bước.
| Tình huống | Python | Lời khuyên |
|---|---|---|
$O(n)$, $O(n \log n)$ với $n \le 2 \cdot 10^5$, dùng được sorted, set, dict | ổn | viết Python, nhớ đọc ghi nhanh |
| Số nguyên lớn, xử lý xâu, công thức toán | rất tốt | Python ngắn gọn và ít lỗi hơn |
| Vòng lặp tự viết khoảng $10^7$ bước | sát nút | tối ưu hằng số hoặc chuyển C++ |
| Hai vòng lồng nhau với $n \ge 5000$, QHĐ bảng $10^7$ ô | quá giờ | C++ |
| Quay lui, vét cạn nhiều nhánh, mô phỏng $10^8$ bước | quá giờ | C++ |
| Đệ quy sâu trên $10^5$ tầng | rủi ro | khử đệ quy, hoặc C++ (cẩn thận ngăn xếp trên Windows) |
| Đề thi không có hệ số bù thời gian cho Python | thiệt | bài nặng nhất nên viết C++ |
| Máy chấm có PyPy (như Codeforces) | khá hơn | vòng lặp số nguyên nhanh hơn nhiều lần, nhưng vẫn nên đo thử |
Bảng 6. Chọn ngôn ngữ cho từng bài. Lời khuyên cho bạn thi HSG: thành thạo một ngôn ngữ chính, nhưng đọc hiểu được ngôn ngữ còn lại để chuyển khi cần.
def main(). 2. Đọc bằng sys.stdin.buffer.read().split() hoặc sys.stdin.readline. 3. In một lần bằng join. 4. Không có x in list, list.index, pop(0), cắt lát trong vòng lặp lớn. 5. Mảng 2 chiều tạo bằng list comprehension. 6. Có đệ quy thì đã nâng giới hạn hoặc khử đệ quy. 7. Thử một test lớn nhất (sinh bằng code như bài 22) và đo thời gian trước khi nộp.- Collecting Numbers (CSES 2216) (Dễ)
- Đếm Số Nguyên Tố (MK119SNT) (Dễ)
- Giải Cứu Đàn Gà (Codeforces 650A Watchmen) (Trung bình)
- Ferris Wheel (CSES 1090) (Trung bình)
- Restaurant Customers (CSES 1619) (Trung bình)
- Factory Machines (CSES 1620) (Trung bình)
Bài tậpLuyện viết Python đủ nhanh
Cho dãy $n$ số nguyên ($1 \le n \le 10^6$, $|a_i| \le 10^9$). In trên một dòng bốn số: tổng, giá trị nhỏ nhất, giá trị lớn nhất và số lượng số chẵn của dãy.
5
3 -4 8 1 614 -4 8 3📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
sys.stdin.buffer.read().split() và dùng sum, min, max có sẵn. Số lẻ có bit cuối bằng 1 nên số lượng số chẵn là n - sum(x & 1 for x in a) (trong Python, -3 & 1 vẫn bằng 1). Tổng có thể tới $10^{15}$: C++ phải dùng long long. Mẫu: tổng $3 - 4 + 8 + 1 + 6 = 14$, ba số chẵn là −4, 8, 6.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    long long s = 0, mn = LLONG_MAX, mx = LLONG_MIN;
    int even = 0;
    for(int i = 0; i < n; i++){
        long long x;
        cin >> x;
        s += x;
        mn = min(mn, x);
        mx = max(mx, x);
        if(x % 2 == 0) even++;
    }
    cout << s << " " << mn << " " << mx << " " << even;
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
a = list(map(int, data[1:n + 1]))
odd = sum(x & 1 for x in a) # x & 1 = 1 khi x lẻ (kể cả số âm)
print(sum(a), min(a), max(a), n - odd)
main()Cho dãy $n$ số nguyên ($n \le 2 \cdot 10^5$, $|a_i| \le 10^9$) và $q$ truy vấn ($q \le 2 \cdot 10^5$), mỗi truy vấn gồm $l$, $r$ ($1 \le l \le r \le n$). Với mỗi truy vấn in ra $a_l + a_{l+1} + \cdots + a_r$ trên một dòng.
Dòng đầu: $n$, $q$. Dòng hai: dãy $a$. Tiếp theo là $q$ dòng truy vấn.
5 3
1 2 3 4 5
1 3
2 5
4 46
14
4📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
[0] + list(accumulate(a)). Phần dễ bị quá giờ là in $2 \cdot 10^5$ dòng: gom vào list rồi join một lần. Mẫu: $1 + 2 + 3 = 6$, $2 + 3 + 4 + 5 = 14$.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

long long P[200005];

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n, q;
    cin >> n >> q;
    for(int i = 1; i <= n; i++){ long long x; cin >> x; P[i] = P[i - 1] + x; }
    while(q--){
        int l, r;
        cin >> l >> r;
        cout << P[r] - P[l - 1] << '\n';
    }
    return 0;
}
import sys
from itertools import accumulate
def main():
data = sys.stdin.buffer.read().split()
n, q = int(data[0]), int(data[1])
P = [0] + list(accumulate(map(int, data[2:2 + n])))
out = []
pos = 2 + n
for _ in range(q):
l, r = int(data[pos]), int(data[pos + 1])
pos += 2
out.append(P[r] - P[l - 1])
sys.stdout.write('\n'.join(map(str, out)) + '\n')
main()Lớp có $n$ bạn đã có mặt, mỗi bạn có một mã gồm chữ cái và chữ số (không quá 20 ký tự). Thầy hỏi $q$ lần, mỗi lần một mã; với mỗi câu hỏi in CO nếu bạn có mã đó đã có mặt, ngược lại in KHONG. Giới hạn $n, q \le 2 \cdot 10^5$.
Dòng đầu: $n$, $q$. Dòng hai: $n$ mã có mặt. Dòng ba: $q$ mã được hỏi.
3 4
HS01 HS07 an22
HS07 HS02 an22 AN22CO
KHONG
CO
KHONG📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
x in a thì mỗi câu hỏi tốn $O(n)$, tổng $4 \cdot 10^{10}$: quá giờ cả với C++. Lưu vào set (C++: unordered_set<string> hoặc set<string>) thì mỗi câu hỏi $O(1)$. Trong Python có thể để nguyên các mã ở dạng bytes vì ta chỉ so sánh bytes với bytes, không cần decode. Chú ý chữ hoa khác chữ thường: AN22 không phải an22.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n, q;
    cin >> n >> q;
    unordered_set<string> s;
    s.reserve(2 * n + 1);
    for(int i = 0; i < n; i++){ string x; cin >> x; s.insert(x); }
    while(q--){
        string x;
        cin >> x;
        cout << (s.count(x) ? "CO" : "KHONG") << '\n';
    }
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split()
n, q = int(data[0]), int(data[1])
s = set(data[2:2 + n]) # tập các mã (dạng bytes)
out = ['CO' if x in s else 'KHONG' for x in data[2 + n:2 + n + q]]
sys.stdout.write('\n'.join(out) + '\n')
main()Cho $n$ từ ($n \le 2 \cdot 10^5$, mỗi từ gồm chữ cái thường, dài không quá 15) và số $k$. In ra $k$ từ xuất hiện nhiều nhất, mỗi dòng gồm từ và số lần xuất hiện. Hai từ có cùng số lần thì từ nhỏ hơn theo thứ tự từ điển đứng trước. Nếu số từ khác nhau ít hơn $k$ thì in tất cả.
Dòng đầu: $n$, $k$. Dòng hai: $n$ từ.
7 2
meo cho ga cho meo ca meomeo 3
cho 2📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
Counter (C++: map<string, int>), rồi sắp các cặp (từ, số lần) với key (-số_lần, từ): đổi dấu để số lần giảm dần, còn từ vẫn tăng dần. Trong C++ viết hàm so sánh tương ứng. Mẫu: meo 3 lần, cho 2 lần; ga và ca cùng 1 lần, nếu $k = 3$ thì in ca vì ca < ga.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n, k;
    cin >> n >> k;
    map<string, int> cnt;
    for(int i = 0; i < n; i++){ string w; cin >> w; cnt[w]++; }
    vector<pair<string, int>> v(cnt.begin(), cnt.end());
    sort(v.begin(), v.end(), [](const pair<string, int> &a, const pair<string, int> &b){
        if(a.second != b.second) return a.second > b.second;   // nhiều lần hơn đứng trước
        return a.first < b.first;                               // bằng nhau: theo từ điển
    });
    for(int i = 0; i < k && i < (int)v.size(); i++) cout << v[i].first << " " << v[i].second << '\n';
    return 0;
}
import sys
from collections import Counter
def main():
data = sys.stdin.buffer.read().split()
n, k = int(data[0]), int(data[1])
cnt = Counter(data[2:2 + n])
best = sorted(cnt.items(), key=lambda t: (-t[1], t[0]))[:k]
sys.stdout.write('\n'.join(w.decode() + ' ' + str(c) for w, c in best) + '\n')
main()Cho dãy $n$ số nguyên ($n \le 2 \cdot 10^5$, $|a_i| \le 10^9$) và $q$ câu hỏi ($q \le 2 \cdot 10^5$), mỗi câu cho một số $x$. Với mỗi câu, in số phần tử của dãy không vượt quá $x$.
Dòng đầu: $n$, $q$. Dòng hai: dãy $a$. Dòng ba: $q$ số $x$.
5 4
7 2 9 2 5
2 6 1 1002
3
0
5📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
bisect_right(a, x) trong Python, upper_bound(a, a + n, x) - a trong C++ (xem lại bài 16). Mẫu: dãy sắp xếp là 2 2 5 7 9; có 2 số $\le 2$, 3 số $\le 6$.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int a[200005];

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n, q;
    cin >> n >> q;
    for(int i = 0; i < n; i++) cin >> a[i];
    sort(a, a + n);
    while(q--){
        int x;
        cin >> x;
        cout << upper_bound(a, a + n, x) - a << '\n';
    }
    return 0;
}
import sys
from bisect import bisect_right
def main():
data = sys.stdin.buffer.read().split()
n, q = int(data[0]), int(data[1])
a = sorted(map(int, data[2:2 + n]))
out = [bisect_right(a, x) for x in map(int, data[2 + n:2 + n + q])]
sys.stdout.write('\n'.join(map(str, out)) + '\n')
main()Một băng chuyền ban đầu rỗng. Có $Q$ lệnh ($Q \le 2 \cdot 10^5$), mỗi lệnh thuộc một trong bốn loại:
1 x: đặt kiện hàng mã $x$ vào cuối băng;2 x: đặt kiện hàng mã $x$ vào đầu băng;3: lấy kiện ở đầu băng ra và in mã của nó;4: lấy kiện ở cuối băng ra và in mã của nó.
Nếu băng rỗng khi gặp lệnh 3 hoặc 4 thì in RONG. Sau khi làm hết, in thêm một dòng là số kiện còn lại trên băng.
6
1 5
1 7
2 3
3
4
33
7
5
0📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
deque: thêm, bớt ở cả hai đầu đều $O(1)$. Nếu dùng list và insert(0, x), pop(0) thì mỗi lệnh ở đầu tốn $O(n)$, $2 \cdot 10^5$ lệnh có thể mất vài giây. Mẫu: sau ba lệnh đặt, băng là 3 5 7; lấy đầu được 3, lấy cuối được 7, lấy đầu được 5; còn 0 kiện.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int Q;
    cin >> Q;
    deque<long long> d;
    while(Q--){
        int t;
        cin >> t;
        if(t == 1){ long long x; cin >> x; d.push_back(x); }
        else if(t == 2){ long long x; cin >> x; d.push_front(x); }
        else if(d.empty()) cout << "RONG\n";
        else if(t == 3){ cout << d.front() << '\n'; d.pop_front(); }
        else { cout << d.back() << '\n'; d.pop_back(); }
    }
    cout << d.size() << '\n';
    return 0;
}
import sys
from collections import deque
def main():
data = sys.stdin.buffer.read().split()
Q = int(data[0])
d = deque()
out = []
pos = 1
for _ in range(Q):
t = data[pos]; pos += 1
if t == b'1':
d.append(data[pos]); pos += 1 # giữ mã ở dạng bytes, in ra mới decode
elif t == b'2':
d.appendleft(data[pos]); pos += 1
elif not d:
out.append('RONG')
elif t == b'3':
out.append(d.popleft().decode())
else:
out.append(d.pop().decode())
out.append(str(len(d)))
sys.stdout.write('\n'.join(out) + '\n')
main()Cho bảng $n \times m$ số nguyên không âm ($n, m \le 1000$, mỗi số $\le 10^9$) và $q$ câu hỏi ($q \le 10^5$). Mỗi câu hỏi gồm $r_1, c_1, r_2, c_2$ ($1 \le r_1 \le r_2 \le n$, $1 \le c_1 \le c_2 \le m$): in tổng các số trong hình chữ nhật có góc trên trái $(r_1, c_1)$ và góc dưới phải $(r_2, c_2)$.
3 4 3
1 2 3 4
5 6 7 8
9 10 11 12
1 1 2 2
2 2 3 4
3 1 3 114
54
9📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
[[0] * (m + 1)] * (n + 1)), và dựng $P$ không bằng hai vòng lặp $10^6$ bước thuần mà theo từng hàng: hàng $i$ của $P$ = hàng $i - 1$ của $P$ cộng với accumulate của hàng $i$ trong bảng, ghép bằng zip. Tổng có thể tới $10^{15}$ nên C++ dùng long long. Mẫu: $1 + 2 + 5 + 6 = 14$.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

long long P[1005][1005];

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n, m, q;
    cin >> n >> m >> q;
    for(int i = 1; i <= n; i++)
        for(int j = 1; j <= m; j++){
            long long x;
            cin >> x;
            P[i][j] = P[i - 1][j] + P[i][j - 1] - P[i - 1][j - 1] + x;
        }
    while(q--){
        int r1, c1, r2, c2;
        cin >> r1 >> c1 >> r2 >> c2;
        cout << P[r2][c2] - P[r1 - 1][c2] - P[r2][c1 - 1] + P[r1 - 1][c1 - 1] << '\n';
    }
    return 0;
}
import sys
from itertools import accumulate
def main():
data = sys.stdin.buffer.read().split()
n, m, q = int(data[0]), int(data[1]), int(data[2])
P = [[0] * (m + 1)] # hàng 0 toàn số 0, mỗi hàng là một list RIÊNG
pos = 3
for _ in range(n):
row = accumulate(map(int, data[pos:pos + m])) # cộng dồn trên hàng hiện tại
pos += m
up = P[-1]
P.append([0] + [x + y for x, y in zip(up[1:], row)])
out = []
for _ in range(q):
r1, c1, r2, c2 = map(int, data[pos:pos + 4])
pos += 4
out.append(P[r2][c2] - P[r1 - 1][c2] - P[r2][c1 - 1] + P[r1 - 1][c1 - 1])
sys.stdout.write('\n'.join(map(str, out)) + '\n')
main()Công ty có $n$ người ($n \le 2 \cdot 10^5$), người $i$ có sếp trực tiếp $p_i$ ($p_i = 0$ nếu người đó không có sếp; có thể có nhiều người như vậy; đảm bảo không có vòng tròn). Cấp dưới của một người gồm cấp dưới trực tiếp, cấp dưới của cấp dưới, … In số cấp dưới của từng người $1, 2, \ldots, n$ trên một dòng.
6
0 1 1 2 2 04 2 0 0 0 0📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
sub[p[v]] += sub[v] + 1. Khi xét $v$, mọi người dưới $v$ có cấp lớn hơn nên đã được xét xong. Mẫu: người 1 có cấp dưới 2, 3, 4, 5.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int n, p[200005], lv[200005];
long long sub[200005];

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    cin >> n;
    for(int i = 1; i <= n; i++) cin >> p[i];
    vector<int> st;
    for(int i = 1; i <= n; i++){                     // tính cấp bằng ngăn xếp tự quản
        int u = i;
        while(u != 0 && lv[u] == 0){ st.push_back(u); u = p[u]; }
        while(!st.empty()){
            int v = st.back(); st.pop_back();
            lv[v] = (p[v] == 0) ? 1 : lv[p[v]] + 1;
        }
    }
    vector<int> order(n);
    iota(order.begin(), order.end(), 1);
    sort(order.begin(), order.end(), [](int a, int b){ return lv[a] > lv[b]; });   // cấp sâu trước
    for(int v : order)
        if(p[v] != 0) sub[p[v]] += sub[v] + 1;
    for(int i = 1; i <= n; i++) cout << sub[i] << " ";
    return 0;
}
import sys
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
p = [0] + [int(x) for x in data[1:n + 1]]
lv = [0] * (n + 1)
st = []
for i in range(1, n + 1): # tính cấp bằng ngăn xếp tự quản
u = i
while u != 0 and lv[u] == 0:
st.append(u)
u = p[u]
while st:
v = st.pop()
lv[v] = 1 if p[v] == 0 else lv[p[v]] + 1
sub = [0] * (n + 1)
for v in sorted(range(1, n + 1), key=lv.__getitem__, reverse=True): # cấp sâu trước
if p[v]:
sub[p[v]] += sub[v] + 1
sys.stdout.write(' '.join(map(str, sub[1:])) + '\n')
main()
- Không biết học gì trước, học gì sau, học lan man nên kiến thức bị hổng.
- Bí bài không ai gỡ, ngồi cả buổi vẫn không ra rồi bỏ cuộc.
- Code chạy được nhưng không đủ điểm, không biết sai ở đâu, chậm ở đâu.
- Không có đề thi thử và người chấm, nên không biết mình đang ở mức nào.
- Dễ nản giữa chừng khi không có ai theo sát.
- Lộ trình 111 buổi video sắp sẵn từ dòng code đầu tiên đến đề HSG thật của các tỉnh.
- Thầy trực tiếp gỡ bí, chữa bài cho từng em qua nhóm Zalo riêng.
- Hệ thống chấm bài tự động 24/7 và thi thử HSG hằng tuần để biết chính xác mình đang ở đâu.
- Đóng học phí một lần, thầy kèm lâu dài: từ thi chuyên Tin đến HSG quốc gia và cả khi lên đại học.
Nhận xét
Đăng nhận xét