
Chuyên đề 5: Xử lý xâu trong đề thi bằng C++ và Python: getline, chuẩn hoá họ tên, tách số, đếm tần suất, nén xâu RLE
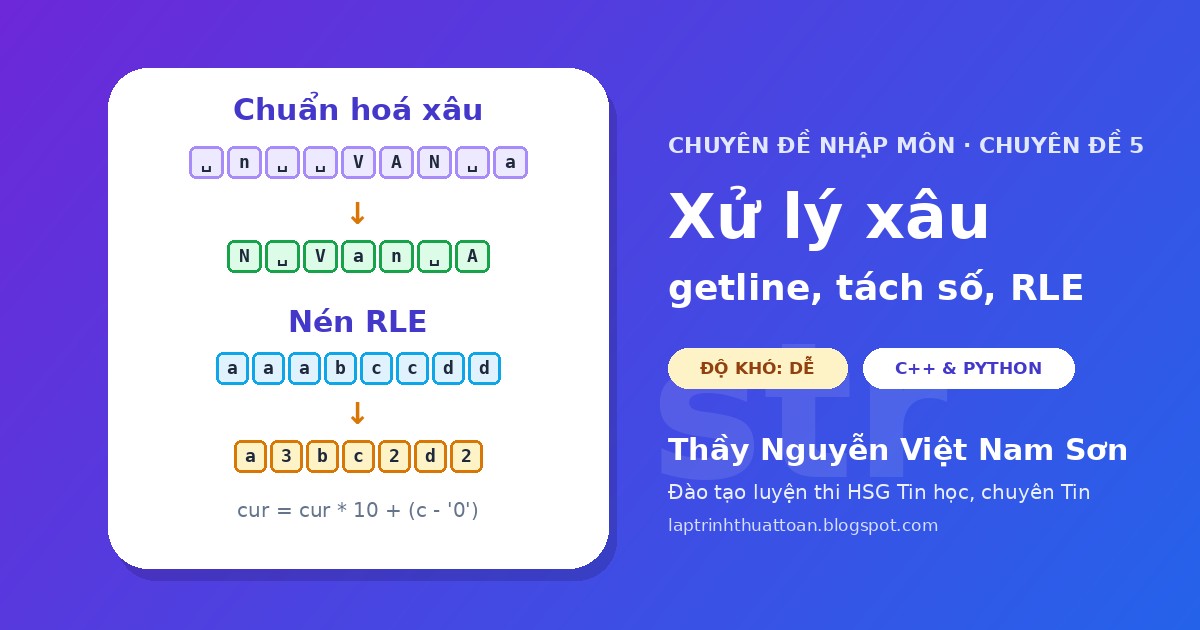
Lời mở đầu
Ở bài 8: Xâu ký tự em đã biết kiểu char, bảng mã ASCII, kiểu string, các hàm có sẵn và những bài kinh điển như xâu đối xứng, đếm từ. Chuyên đề này không giảng lại những thứ đó mà đi thẳng vào dạng bài trong đề thi: đề cho cả một dòng họ tên lộn xộn khoảng trắng, một đoạn văn lẫn chữ lẫn số, hay một xâu dài cả triệu ký tự cần nén lại. Đây thường là câu 1 hoặc câu 2 của đề HSG THCS, đề tuyển sinh vào 10 chuyên Tin: dễ lấy điểm, nhưng cũng dễ mất điểm nhất vì những lỗi rất “vặt”.
Mình sẽ dùng lại map ở bài 11, mảng đếm phân phối ở bài 13 và cách so sánh số lớn dạng xâu ở chuyên đề 3: Số nguyên lớn. Mỗi kỹ thuật đều có ví dụ chạy tay, mô phỏng bấm từng bước và code C++ lẫn Python.
getline sau cin, ký tự '\r' cuối dòng, đọc tới hết file, input().strip() trong Python); chuẩn hoá xâu tại chỗ bằng con trỏ đọc và con trỏ ghi: xoá khoảng trắng thừa, viết hoa chữ cái đầu, chuẩn hoá họ tên; tách từ và tách các số ra khỏi xâu lẫn chữ; đếm tần suất ký tự bằng mảng 26 hoặc 256 phần tử, đếm từ bằng map, kiểm tra anagram, tìm ký tự xuất hiện nhiều nhất; nén xâu RLE và giải nén; so sánh, sắp xếp số rất lớn dạng xâu. Có 2 khung chạy tay, 3 mô phỏng bấm từng bước và 8 bài tập kèm gợi ý.Lộ trình bài viết, bấm vào từng phần để nhảy tới:
Phần 1Bẫy đọc dữ liệu: getline, ký tự '\r' và đọc tới hết file
Với bài xâu, đọc đúng dữ liệu đã là một nửa lời giải. Trước hết em nhớ lại hai cách đọc trong C++ (đã học ở bài 8):
cin >> sbỏ qua khoảng trắng ở đầu, rồi đọc tới khoảng trắng tiếp theo. Vậy nó chỉ đọc được một từ.getline(cin, s)đọc cả dòng, kể cả khoảng trắng, tới dấu xuống dòng (dấu xuống dòng bị bỏ đi, không nằm trongs).
Đề cho họ tên, địa chỉ, một câu văn… thì phải dùng getline. Và đây là cái bẫy số một: đề cho số $n$ ở dòng đầu, rồi $n$ dòng họ tên. Em viết cin >> n; rồi getline(cin, s); và thấy họ tên đầu tiên bị rỗng!
Hình 1. Sau cin >> n, dấu xuống dòng ⏎ ngay sau số 3 vẫn còn nằm trong bộ đệm. Lệnh getline đầu tiên gặp ngay ⏎ nên trả về xâu rỗng.
cin >> n đọc xong chữ số 3 thì dừng trước dấu xuống dòng, không “ăn” nó. Có ba cách sửa, em chọn một và dùng quen tay:
- Gọi thêm một
getline(cin, rac);bỏ đi phần còn lại của dòng chứa $n$ (an toàn nhất, kể cả khi sau $n$ còn dấu cách thừa). cin.ignore();bỏ đúng 1 ký tự. Sai nếu sau số $n$ còn dấu cách hoặc'\r'.getline(cin >> ws, s);trong đówsbỏ qua mọi khoảng trắng và dấu xuống dòng trước khi đọc dòng. Gọn, nhưng cũng bỏ luôn khoảng trắng đầu dòng và các dòng trống.
Bẫy số hai: ký tự '\r' ở cuối dòng. File test soạn trên Windows kết thúc mỗi dòng bằng hai ký tự '\r' '\n', còn máy chấm thường chạy Linux chỉ coi '\n' là xuống dòng. Thế là getline trả về "Nguyen Van An\r": in ra trông vẫn bình thường, nhưng s.size() thừa 1, so sánh s == "YES" luôn sai, ký tự cuối không phải chữ cái. Khi đọc bằng cin >> thì không sao vì '\r' được coi là khoảng trắng. Chỉ cần một dòng phòng thủ sau mỗi getline:
if(!s.empty() && s.back() == '\r') s.pop_back();| Cách đọc | Dòng vào ␣␣Le␣␣An␣\r | Ghi chú |
|---|---|---|
C++ cin >> s | "Le" | chỉ một từ; gọi lần nữa được "An" |
C++ getline(cin, s) | "␣␣Le␣␣An␣\r" | giữ nguyên mọi thứ, kể cả '\r' |
Python input() | "␣␣Le␣␣An␣\r" | trên Linux cũng giữ '\r'! |
Python input().strip() | "Le␣␣An" | bỏ khoảng trắng và '\r' ở hai đầu |
Python input().split() | ['Le', 'An'] | tách từ, bỏ mọi khoảng trắng thừa |
Python input().split(' ') | ['', '', 'Le', '', 'An', '\r'] | có tham số thì không gộp khoảng trắng: sinh xâu rỗng |
Bảng 1. Cùng một dòng dữ liệu, mỗi cách đọc cho một kết quả khác nhau (␣ là khoảng trắng).
Ví dụ. Dòng đầu là $n$, sau đó là $n$ câu (mỗi câu một dòng, có thể chứa khoảng trắng). In ra câu dài nhất và độ dài của nó. Code dưới đây có đủ hai lớp phòng thủ: bỏ phần còn lại của dòng chứa $n$, và bỏ '\r' cuối mỗi dòng. Bộ test thứ hai của code chính là file kiểu Windows.
Xem code C++ / Python: đọc n rồi n dòng có khoảng trắng bằng getline (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    int n;
    cin >> n;
    string s, best = "";
    getline(cin, s);                                     // "ăn" nốt phần còn lại của dòng chứa n
    for(int i = 0; i < n; i++){
        getline(cin, s);                                 // đọc cả dòng, kể cả khoảng trắng
        if(!s.empty() && s.back() == '\r') s.pop_back(); // file soạn trên Windows có '\r' ở cuối
        if(s.size() > best.size()) best = s;
    }
    cout << best << "\n" << best.size();
    return 0;
}
n = int(input()) # int() tự bỏ khoảng trắng và '\r' hai đầu
best = ''
for _ in range(n):
s = input().rstrip('\r') # trên Linux, input() KHÔNG tự bỏ '\r'
if len(s) > len(best):
best = s
print(best)
print(len(best))while(getline(cin, s)){ // dừng khi hết file
if(!s.empty() && s.back() == '\r') s.pop_back();
// ... xử lý dòng s ...
}
while(cin >> w){ ... } // đọc từng từ tới hết filefor line in sys.stdin: hoặc sys.stdin.read() để lấy toàn bộ rồi split(). Cách đọc file bằng freopen em xem lại bài 9.s = input().strip() khi cần cả dòng, hoặc input().split() khi cần các từ. Chỉ khi đề yêu cầu giữ nguyên khoảng trắng đầu, cuối dòng thì mới dùng input().rstrip('\r\n'). Với dữ liệu lớn (hàng trăm nghìn dòng) dùng sys.stdin.readline cho nhanh, nhưng nhớ hàm này giữ cả '\n' ở cuối.Phần 2Chuẩn hoá xâu: khoảng trắng thừa, viết hoa đầu từ, chuẩn hoá họ tên
Dạng bài “chuẩn hoá” gặp rất nhiều trong đề: cho một dòng như "␣␣nGUYEN␣␣␣van␣␣␣␣aN␣␣", hãy đưa về dạng chuẩn "Nguyen Van An". Quy tắc thường gồm:
- không có khoảng trắng ở đầu và cuối xâu;
- giữa hai từ có đúng một khoảng trắng;
- chữ cái đầu mỗi từ viết hoa, các chữ còn lại viết thường.
Cách nhiều bạn nghĩ tới đầu tiên là tìm hai khoảng trắng liền nhau rồi erase một cái, lặp tới khi hết. Cách đó đúng nhưng mỗi lần erase phải dồn cả phần sau của xâu, nên với xâu dài $10^5$ toàn khoảng trắng có thể mất cỡ $n^2 = 10^{10}$ phép tính. Cách chuẩn là dùng hai con trỏ trên chính xâu đó:
- con trỏ đọc
iđi qua từng ký tự từ trái sang phải; - con trỏ ghi
jlà chỗ sẽ ghi ký tự tiếp theo của kết quả. Phầns[0..j-1]luôn là kết quả đã chuẩn hoá.
Gặp ký tự khác khoảng trắng: ghi vào s[j], viết hoa nếu nó đứng đầu từ (tức j == 0 hoặc s[j-1] là khoảng trắng). Gặp khoảng trắng: chỉ ghi khi ngay trước đó (s[j-1]) là một chữ, nhờ vậy cả dãy khoảng trắng chỉ để lại một. Cuối cùng bỏ khoảng trắng ở cuối (nếu có) và cắt xâu còn j ký tự. Vì j không bao giờ vượt i, việc ghi đè không làm hỏng ký tự chưa đọc.
Em bấm Tiếp để thấy hai con trỏ chạy. Hãy để ý: khoảng trắng đầu xâu và khoảng trắng thừa bị “nuốt” mà không cần dồn chỗ:
| Xâu vào | Xoá khoảng trắng thừa | Chuẩn hoá họ tên |
|---|---|---|
"␣␣nGUYEN␣␣␣van␣␣␣␣aN␣␣" | "nGUYEN van aN" | "Nguyen Van An" |
"tran" | "tran" | "Tran" |
"␣␣␣" | "" | "" |
"LE␣thi␣HOA" | "LE thi HOA" | "Le Thi Hoa" |
Bảng 2. Các trường hợp cần thử khi viết hàm chuẩn hoá: thừa khoảng trắng ở cả hai đầu, một từ, toàn khoảng trắng.
Xem code C++ / Python: chuẩn hoá họ tên bằng con trỏ đọc và con trỏ ghi (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

string chuanHoa(string s){
    int j = 0;                                    // j: vị trí ghi tiếp theo
    for(int i = 0; i < (int)s.size(); i++){       // i: vị trí đọc
        char c = s[i];
        if(c != ' '){
            if(j == 0 || s[j - 1] == ' ') c = toupper(c);   // chữ đầu từ: viết hoa
            else c = tolower(c);                            // các chữ sau: viết thường
            s[j++] = c;
        } else if(j > 0 && s[j - 1] != ' '){
            s[j++] = ' ';                         // chỉ giữ MỘT khoảng trắng giữa hai từ
        }
    }
    if(j > 0 && s[j - 1] == ' ') j--;             // bỏ khoảng trắng ở cuối
    s.resize(j);
    return s;
}

int main(){
    string s;
    getline(cin, s);
    if(!s.empty() && s.back() == '\r') s.pop_back();
    cout << chuanHoa(s);
    return 0;
}
s = input()
words = s.split() # split() không tham số: tự bỏ mọi khoảng trắng thừa (cả '\r', tab)
print(' '.join(w[0].upper() + w[1:].lower() for w in words))Trong Python, s.split() (không tham số) đã tự bỏ mọi khoảng trắng thừa, nên chuẩn hoá chỉ còn một dòng. Nhưng em cẩn thận với hai hàm “tiện lợi” sau:
| Biểu thức | Kết quả | Nhận xét |
|---|---|---|
"nGUYEN van".title() | "Nguyen Van" | đúng như mong muốn |
"o'neil".title() | "O'Neil" | viết hoa cả chữ sau dấu nháy |
"lop 9a1".title() | "Lop 9A1" | viết hoa chữ sau chữ số: thường là SAI đề |
"nGUYEN".capitalize() | "Nguyen" | hoa chữ đầu, thường các chữ còn lại; chỉ dùng cho một từ |
Bảng 3. title() coi mọi ký tự không phải chữ cái là chỗ bắt đầu từ mới. An toàn nhất là tự viết w[0].upper() + w[1:].lower() cho từng từ sau split().
toupper, tolower, isalpha, isdigit trong C++ chỉ hiểu chữ không dấu. Chữ có dấu như “ễ” trong UTF-8 chiếm 2 đến 3 byte, mỗi byte là một char âm; truyền char âm vào isalpha có thể làm chương trình chạy sai. Vì thế đề thi gần như luôn cho tiếng Việt không dấu. Nếu buộc phải dùng, hãy ép kiểu: isalpha((unsigned char)c), và nhớ s.size() đếm byte, không phải số chữ.Phần 3Tách từ và tách các số ra khỏi xâu lẫn chữ
Tách từ. Bài 8 đã đếm từ bằng cách đếm chỗ chuyển từ khoảng trắng sang chữ. Khi cần lấy ra từng từ, cách gọn nhất trong C++ là stringstream: nó biến xâu thành một “luồng nhập” giống hệt cin, nên ss >> w lấy lần lượt từng từ và tự bỏ mọi khoảng trắng thừa. Python thì có sẵn s.split().
stringstream ss(s);
string w;
vector<string> words;
while(ss >> w) words.push_back(w);   // "␣␣Hoc␣␣tap␣" → {"Hoc", "tap"}
Nếu các từ ngăn cách bởi dấu câu ("an,cam; chuoi.mit") thì trước khi tách, em thay mọi ký tự không phải chữ cái bằng khoảng trắng. Đây là mẹo dùng nhiều nhất trong phần này, bài đếm từ ở phần 4 dùng đúng mẹo đó.
Tách số. Đề cho một xâu lẫn chữ lẫn số, ví dụ "Lop 9A1 co 35 hs, 007 ban dat giai 2026", yêu cầu tìm các số trong đó (một số là một đoạn liên tiếp các chữ số), tính tổng, đếm, tìm số lớn nhất… Ta duyệt từng ký tự và giữ biến cur là giá trị của số đang đọc dở:
- gặp chữ số $d$:
cur = cur * 10 + d(giống ghép chữ số ở chuyên đề 1); - gặp ký tự khác mà đang đọc dở một số: số đó kết thúc, xử lý
currồi đặt lạicur = 0; - hết xâu mà vẫn đang đọc dở: phải xử lý nốt số cuối cùng. Đây là lỗi kinh điển nhất của dạng bài này!
| Đoạn | Ký tự | cur | Việc làm | Tổng |
|---|---|---|---|---|
Lop␣ | chữ, khoảng trắng | 0 | bỏ qua | 0 |
9 | chữ số | 9 | bắt đầu số mới | 0 |
A | chữ | 0 | số 9 kết thúc, cộng vào | 9 |
1␣ | chữ số rồi khoảng trắng | 1 → 0 | số 1 kết thúc | 10 |
35, | hai chữ số rồi dấu phẩy | 3 → 35 → 0 | số 35 kết thúc | 45 |
007␣ | ba chữ số | 0 → 0 → 7 → 0 | số 7 kết thúc (0 đầu tự mất) | 52 |
2026 | bốn chữ số, hết xâu | 2026 | cộng nốt sau vòng lặp! | 2078 |
Bảng 4. Chạy tay ví dụ mặc định của mô phỏng: tách được 5 số 9, 1, 35, 7, 2026, tổng là 2078.
Xem code C++ / Python: tách các số trong một dòng, đếm và tính tổng (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string s;
    getline(cin, s);
    long long cur = 0, sum = 0;
    int cnt = 0;
    bool dangDoc = false;                        // đang đọc dở một số?
    for(char c : s){
        if(c >= '0' && c <= '9'){
            cur = cur * 10 + (c - '0');          // ghép thêm một chữ số
            dangDoc = true;
        } else if(dangDoc){                      // số vừa kết thúc
            sum += cur; cnt++;
            cur = 0; dangDoc = false;
        }
    }
    if(dangDoc){ sum += cur; cnt++; }            // ĐỪNG QUÊN số nằm ở cuối xâu
    cout << cnt << " " << sum;
    return 0;
}
s = input()
cur = total = cnt = 0
dang_doc = False # đang đọc dở một số?
for c in s:
if '0' <= c <= '9':
cur = cur * 10 + int(c) # ghép thêm một chữ số
dang_doc = True
elif dang_doc: # số vừa kết thúc
total += cur
cnt += 1
cur, dang_doc = 0, False
if dang_doc: # ĐỪNG QUÊN số nằm ở cuối xâu
total += cur
cnt += 1
print(cnt, total)Em bấm từng dòng code để thấy rõ vai trò của dòng if(dangDoc) sau vòng lặp. Thử ví dụ “số ở cuối”: nếu xoá dòng đó, số 10 sẽ biến mất khỏi tổng.
- Số rất dài (hơn 18 chữ số): không ghép vào
long longđược nữa, hãy giữ số dưới dạng xâu (nối từng chữ số vàostring cur) rồi so sánh, cộng theo kiểu số lớn ở phần 5 và chuyên đề 3. - Số âm: dấu
-đứng ngay trước chữ số đầu tiên thì số đó âm (bài tập 2). - Số thực như
3.14: ghép phần nguyên, gặp dấu chấm rồi ghép tiếp phần thập phân. - Mẹo lính canh: thêm một ký tự không phải chữ số vào cuối xâu (
s += '#';) trước vòng lặp, khi đó số cuối cùng tự kết thúc trong vòng lặp, khỏi cần xử lý riêng.
import re rồi re.findall(r'[0-9]+', s) trả về danh sách các xâu số. Nhưng em vẫn nên tự viết được vòng lặp, vì đề hay thêm luật lạ mà re khó diễn đạt.Phần 4Đếm tần suất ký tự và từ: mảng đếm, map, anagram
Rất nhiều câu hỏi về xâu thật ra là câu hỏi về số lần xuất hiện: ký tự nào xuất hiện nhiều nhất? hai xâu có gồm đúng các chữ cái như nhau không? có thể xếp lại thành xâu đối xứng không? Công cụ là mảng đếm, đúng kỹ thuật đếm phân phối ở bài 13, chỉ khác là chỉ số là ký tự:
- xâu chỉ gồm chữ thường:
int cnt[26], chữcứng với ôc - 'a'('a'→ 0,'b'→ 1, …,'z'→ 25); - xâu có đủ loại ký tự (hoa, thường, chữ số, dấu câu):
int cnt[256], dùng luôn mã ASCII làm chỉ số:cnt[(unsigned char)c]++; - đếm từ (không thể làm chỉ số mảng): dùng
map<string, int>như ở bài 11, Python códicthoặccollections.Counter.
Anagram. Hai xâu là anagram (hoán vị của nhau) nếu xáo trộn các ký tự của xâu này thì được xâu kia, ví dụ listen và silent. Cách đơn giản là sắp xếp cả hai xâu rồi so sánh, mất $O(n \log n)$. Cách nhanh hơn, $O(n)$, là đếm: xâu a làm tăng ô đếm, xâu b làm giảm; cuối cùng mọi ô đều bằng 0 thì hai xâu là anagram.
| Chữ | e | i | l | n | s | t |
|---|---|---|---|---|---|---|
sau khi đếm listen | 1 | 1 | 1 | 1 | 1 | 1 |
sau khi trừ silent | 0 | 0 | 0 | 0 | 0 | 0 |
nếu b là silenn | 0 | 0 | 0 | −1 | 0 | 1 |
Bảng 5. Mảng đếm của hai xâu anagram trở về toàn số 0. Chỉ cần một ô khác 0 là kết luận NO.
Khung chạy tay dưới đây chỉ hiện các ô đếm của những chữ có mặt trong hai xâu. Em thử cả hai trường hợp YES và NO:
Ký tự xuất hiện nhiều nhất. Đếm xong thì duyệt 26 ô, giữ ô lớn nhất. Đề thường thêm “nếu nhiều ký tự cùng nhiều nhất thì in ký tự nhỏ nhất theo bảng chữ cái”: duyệt k từ 0 lên 25 và chỉ cập nhật khi lớn hơn hẳn (>, không phải >=) là tự đúng yêu cầu đó. Từ mảng đếm em còn trả lời được nhiều câu khác: ký tự đầu tiên không lặp lại (duyệt xâu lần hai, gặp ký tự có cnt == 1 đầu tiên), xếp lại thành xâu đối xứng được không (có không quá một chữ xuất hiện lẻ lần), số ký tự cần xoá để hai xâu thành anagram (tổng trị tuyệt đối các ô sau khi a cộng, b trừ).
Đếm từ trong đoạn văn. Ghép tất cả lại: đọc tới hết dữ liệu, đưa chữ hoa về chữ thường, biến dấu câu thành khoảng trắng (mẹo ở phần 3), tách từ và đếm bằng map, cuối cùng in các từ theo số lần giảm dần, cùng số lần thì theo thứ tự từ điển. Thứ tự sắp xếp nhiều tiêu chí em đã học ở bài 10; ở đây mình dùng mẹo lưu số lần âm để sort tăng dần cho ra số lần giảm dần.
| Đoạn văn vào | Kết quả |
|---|---|
Hoc, hoc nua; hoc mai!Co cong mai sat, co ngay nen kim. | hoc 3 · co 2 · mai 2 · cong 1 · kim 1 · nen 1 · ngay 1 · nua 1 · sat 1 |
Bảng 6. “Hoc” và “hoc” là cùng một từ sau khi đưa về chữ thường; “co” và “mai” cùng 2 lần nên xếp theo từ điển.
Xem code C++ / Python: đếm số lần xuất hiện của mỗi từ trong đoạn văn (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string text, line;
    while(getline(cin, line)) text += line + " ";        // đọc tới hết dữ liệu
    for(char &c : text){
        if(isalpha((unsigned char)c)) c = tolower(c);    // chữ: đưa về chữ thường
        else c = ' ';                                    // dấu câu, chữ số, '\r'...: thành khoảng trắng
    }
    stringstream ss(text);
    map<string, int> cnt;
    string w;
    while(ss >> w) cnt[w]++;                             // tách từ và đếm
    vector<pair<int, string>> v;
    for(auto &p : cnt) v.push_back({-p.second, p.first}); // số lần âm: sort tăng = nhiều lần trước
    sort(v.begin(), v.end());
    for(auto &p : v) cout << p.second << " " << -p.first << "\n";
    return 0;
}
import sys
from collections import Counter
text = sys.stdin.read().lower()
text = ''.join(c if 'a' <= c <= 'z' else ' ' for c in text) # chỉ giữ chữ cái
cnt = Counter(text.split()) # tách từ và đếm
for w, k in sorted(cnt.items(), key=lambda p: (-p[1], p[0])): # nhiều lần trước, cùng số lần thì theo từ điển
print(w, k)- Chỉ số là chữ cái hoặc ký tự: mảng
cnt[26]/cnt[256], nhanh nhất, nhớ khởi tạo bằng 0 (khai báo toàn cục hoặc= {0}). - Chỉ số là từ, là xâu bất kỳ:
map<string, int>(duyệt ra theo thứ tự từ điển) hoặcunordered_map(nhanh hơn, không có thứ tự). - Python:
Counter(s)đếm ký tự,Counter(s.split())đếm từ,cnt.most_common(k)lấy $k$ phần tử nhiều nhất.
cnt[c - 'a'] khi xâu có cả chữ hoa hoặc chữ số, chỉ số âm hoặc vượt 25 làm hỏng bộ nhớ. Đọc kỹ đề xem xâu gồm những ký tự nào!Phần 5Nén xâu RLE, giải nén và số rất lớn dạng xâu
Nén RLE (Run-Length Encoding, mã hoá độ dài loạt) là dạng bài rất quen trong đề thi: thay mỗi nhóm ký tự giống nhau đứng liền nhau bằng ký tự đó kèm số lần lặp. Đề có nhiều quy ước khác nhau (số đứng trước hay sau, có ghi số 1 không), trong bài này mình dùng: ký tự rồi số lần, nhóm dài 1 thì không ghi số.
Hình 2. Nén RLE: aaabccdddd gồm 4 nhóm, mỗi nhóm thành một mẩu ngắn.
Nén dùng hai con trỏ: i đứng ở đầu nhóm, j chạy sang phải chừng nào s[j] == s[i]. Khi dừng, nhóm là s[i..j-1], dài j - i; ghi kết quả rồi gán i = j. Hai vòng while lồng nhau nhưng mỗi ký tự chỉ được j đi qua đúng một lần, nên tổng cộng vẫn là $O(n)$, chạy tốt với xâu $10^6$ ký tự.
Giải nén ngược lại: đọc một chữ cái, rồi đọc tất cả các chữ số liền sau và ghép thành số lần $k$ đúng như kỹ thuật tách số ở phần 3. Chú ý số lần có thể nhiều chữ số (a12 là 12 chữ a, không phải 1 chữ a rồi 2 cái gì đó), và không có chữ số nào nghĩa là $k = 1$. Em chọn chế độ trong mô phỏng để xem cả hai chiều:
Xem code C++ / Python: nén xâu RLE và giải nén lại (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

string nen(const string &s){
    string res = "";
    int n = s.size(), i = 0;
    while(i < n){
        int j = i;
        while(j < n && s[j] == s[i]) j++;         // nhóm s[i..j-1] gồm các ký tự giống nhau
        res += s[i];
        if(j - i > 1) res += to_string(j - i);    // nhóm dài 1 thì không ghi số
        i = j;                                    // sang nhóm tiếp theo
    }
    return res;
}

string giaiNen(const string &t){
    string res = "";
    int n = t.size(), i = 0;
    while(i < n){
        char c = t[i++];                          // một chữ cái
        long long k = 0;
        while(i < n && t[i] >= '0' && t[i] <= '9') k = k * 10 + (t[i++] - '0');   // các chữ số liền sau
        if(k == 0) k = 1;                         // không có số nghĩa là 1 lần
        res.append(k, c);
    }
    return res;
}

int main(){
    string s;
    cin >> s;
    string t = nen(s);
    cout << t << "\n" << giaiNen(t);
    return 0;
}
def nen(s):
res = []
n, i = len(s), 0
while i < n:
j = i
while j < n and s[j] == s[i]: # nhóm s[i..j-1] gồm các ký tự giống nhau
j += 1
res.append(s[i] + (str(j - i) if j - i > 1 else '')) # nhóm dài 1 thì không ghi số
i = j # sang nhóm tiếp theo
return ''.join(res)
def giai_nen(t):
res = []
n, i = len(t), 0
while i < n:
c = t[i]; i += 1 # một chữ cái
k = 0
while i < n and t[i].isdigit(): # các chữ số liền sau
k = k * 10 + int(t[i]); i += 1
res.append(c * (k if k > 0 else 1)) # không có số nghĩa là 1 lần
return ''.join(res)
s = input().strip()
t = nen(s)
print(t)
print(giai_nen(t))abcd), nén không làm ngắn đi. Với quy ước “luôn ghi số kể cả 1” thì còn tệ hơn: abcd thành a1b1c1d1, dài gấp đôi! Đề hay hỏi thêm câu này, và cũng hay hỏi độ dài sau giải nén: nó có thể cực lớn (a1000000000), khi đó đừng dựng xâu thật mà chỉ cộng các số lần vào biến long long (bài tập 8).Số rất lớn dạng xâu. Một dạng xâu nữa hay gặp: đề cho những số có tới hàng trăm chữ số, chỉ cần so sánh hay sắp xếp chứ không cần tính toán. Ở chuyên đề 3 em đã biết cách so sánh: bỏ các số 0 thừa ở đầu, số nào nhiều chữ số hơn thì lớn hơn, cùng số chữ số thì so sánh từ điển (vì khi cùng độ dài, thứ tự từ điển trùng với thứ tự giá trị). Cái bẫy là so sánh xâu trực tiếp:
| a | b | So sánh xâu a < b | So sánh giá trị | Vì sao |
|---|---|---|---|---|
"10" | "9" | đúng | 10 > 9 | xâu so ký tự đầu: '1' < '9' |
"007" | "12" | đúng | 7 < 12 | đúng nhờ may mắn: '0' < '1' |
"0099" | "100" | sai | 99 < 100 | phải bỏ số 0 đầu trước khi so độ dài |
"123" | "129" | đúng | 123 < 129 | cùng độ dài: so từ điển là đúng |
Bảng 7. So sánh xâu chỉ đúng với giá trị số khi hai xâu cùng độ dài và không có số 0 thừa ở đầu.
Muốn sắp xếp các số lớn, em viết hàm so sánh đúng như trên rồi đưa vào sort. Trong Python còn gọn hơn: sắp xếp theo khoá (len(x), x). Code dưới đây đọc $n$ số (có thể có số 0 thừa ở đầu), in ra dãy tăng dần ở dạng chuẩn:
Xem code C++ / Python: sắp xếp các số rất lớn cho dưới dạng xâu (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

string chuanHoa(const string &s){                 // bỏ các chữ số 0 thừa ở đầu
    size_t p = s.find_first_not_of('0');
    return p == string::npos ? "0" : s.substr(p);
}

bool nhoHon(const string &a, const string &b){    // a < b ? (a, b đã chuẩn hoá)
    if(a.size() != b.size()) return a.size() < b.size();   // ít chữ số hơn thì nhỏ hơn
    return a < b;                                          // cùng độ dài: so sánh từ điển
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    vector<string> v(n);
    for(auto &x : v){ cin >> x; x = chuanHoa(x); }
    sort(v.begin(), v.end(), nhoHon);
    for(auto &x : v) cout << x << " ";
    return 0;
}
import sys
data = sys.stdin.read().split()
n = int(data[0])
v = [x.lstrip('0') or '0' for x in data[1:n + 1]] # bỏ số 0 thừa ở đầu, "000" thành "0"
v.sort(key=lambda x: (len(x), x)) # độ dài trước, rồi từ điển
print(*v)int(s) báo lỗi ValueError: Exceeds the limit (4300 digits) khi xâu dài hơn 4300 chữ số (giới hạn chống tấn công từ chối dịch vụ). Nếu thật sự cần đổi, gọi sys.set_int_max_str_digits(0) ở đầu chương trình. Nhưng với bài chỉ so sánh hay sắp xếp, em đừng đổi sang int: đổi xâu dài $L$ chữ số sang số tốn cỡ $L^2$ phép tính, còn so sánh bằng (len(x), x) vừa nhanh vừa không vướng giới hạn.- Xuất các từ trong chuỗi, mỗi từ một dòng (Dễ)
- Tính Tổng Các Số Trong Xâu (Dễ)
- Đếm Ký Tự (HSG9 TP Đà Nẵng 2018-2019 – Bài 1) (Dễ)
- Họ Hàng (HOHANG) (HSG 19.20) (Dễ)
- Palindrome Reorder (CSES 1755) (Dễ)
- Mạch DNA (HSG9 Hà Nội 2025 – Bài 2) (Dễ)
- Chuỗi hạt bồ đề (PTIT009) (Trung bình)
Bài tậpLuyện xử lý xâu kiểu đề thi
Cho một dòng là họ tên của một học sinh (dài không quá 1000 ký tự), gồm chữ cái tiếng Việt không dấu và khoảng trắng, có thể thừa khoảng trắng ở bất kỳ đâu và viết hoa thường lộn xộn; họ tên có ít nhất hai từ. In ra hai dòng: dòng 1 là họ tên dạng chuẩn (mỗi từ viết hoa chữ đầu, giữa hai từ đúng một khoảng trắng); dòng 2 là tên (từ cuối) viết hoa toàn bộ, tiếp theo là dấu phẩy, một khoảng trắng và phần họ đệm dạng chuẩn.
nGUYEN van aN Nguyen Van An
AN, Nguyen Van📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
getline (có khoảng trắng!), tách từ bằng stringstream hoặc split(), chuẩn hoá từng từ: chữ đầu hoa, còn lại thường. Dòng 2 lấy từ cuối viết hoa hết, rồi in các từ còn lại. Mẫu: ba từ là “Nguyen”, “Van”, “An”; tên là “AN”, họ đệm là “Nguyen Van”.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string s, w;
    getline(cin, s);
    stringstream ss(s);                    // >> tự bỏ khoảng trắng thừa và cả '\r'
    vector<string> v;
    while(ss >> w){
        for(char &c : w) c = tolower(c);
        w[0] = toupper(w[0]);
        v.push_back(w);
    }
    int k = v.size();
    for(int i = 0; i < k; i++) cout << v[i] << (i + 1 < k ? " " : "\n");
    string ten = v[k - 1];
    for(char &c : ten) c = toupper(c);
    cout << ten << ",";
    for(int i = 0; i + 1 < k; i++) cout << " " << v[i];
    return 0;
}
v = [w[0].upper() + w[1:].lower() for w in input().split()]
print(' '.join(v))
print(v[-1].upper() + ', ' + ' '.join(v[:-1]))Cho một dòng dài không quá $10^5$ ký tự gồm chữ cái, chữ số, khoảng trắng và dấu câu. Mỗi đoạn liên tiếp các chữ số là một số (không quá 9 chữ số); nếu ký tự ngay trước đoạn chữ số là dấu - thì số đó là số âm. Tính tổng tất cả các số.
Nhiet do -5 do, sang 12 do, chieu -3, x10-212📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
s[i-1] có phải '-' không. Mẫu có các số $-5$, $12$, $-3$, $10$, $-2$ (đoạn x10-2 chứa hai số), tổng là $12$. Tổng có thể tới $10^{9} \cdot 5 \cdot 10^4$ nên dùng long long. Python có thể dùng re.findall(r'-?[0-9]+', s).Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string s;
    getline(cin, s);
    int n = s.size(), i = 0;
    long long sum = 0;
    while(i < n){
        if(s[i] >= '0' && s[i] <= '9'){
            bool am = (i > 0 && s[i - 1] == '-');     // dấu trừ ngay trước chữ số đầu tiên
            long long cur = 0;
            while(i < n && s[i] >= '0' && s[i] <= '9'){
                cur = cur * 10 + (s[i] - '0');
                i++;
            }
            sum += am ? -cur : cur;
        } else i++;
    }
    cout << sum;
    return 0;
}
import sys, re
s = sys.stdin.readline()
print(sum(int(x) for x in re.findall(r'-?[0-9]+', s)))Cho xâu $s$ gồm chữ cái thường, độ dài không quá $10^6$. Tìm ký tự xuất hiện nhiều lần nhất và số lần xuất hiện của nó. Nếu có nhiều ký tự cùng nhiều nhất, in ký tự nhỏ nhất theo bảng chữ cái.
abracadabraa 5📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
cnt[26], mỗi ký tự c tăng ô c - 'a'. Duyệt $k$ từ 0 tới 25, chỉ cập nhật khi cnt[k] > cnt[best] (lớn hơn hẳn), nhờ đó khi bằng nhau ta giữ chữ nhỏ hơn. Mẫu: a xuất hiện 5 lần, b và r mỗi chữ 2 lần.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int cnt[26];

int main(){
    string s;
    cin >> s;
    for(char c : s) cnt[c - 'a']++;
    int best = 0;
    for(int k = 1; k < 26; k++)
        if(cnt[k] > cnt[best]) best = k;     // lớn hơn hẳn: hoà thì giữ chữ nhỏ hơn
    cout << char('a' + best) << " " << cnt[best];
    return 0;
}
s = input().strip()
cnt = [0] * 26
for c in s:
cnt[ord(c) - 97] += 1
best = 0
for k in range(1, 26):
if cnt[k] > cnt[best]: # lớn hơn hẳn: hoà thì giữ chữ nhỏ hơn
best = k
print(chr(97 + best), cnt[best])Hai câu là đảo chữ của nhau nếu sau khi bỏ hết khoảng trắng và không phân biệt chữ hoa, chữ thường, các chữ cái của câu này xếp lại được thành câu kia. Cho hai câu trên hai dòng (mỗi câu dài không quá $10^5$ ký tự, chỉ gồm chữ cái không dấu và khoảng trắng, có ít nhất một chữ cái). In YES nếu chúng là đảo chữ của nhau, ngược lại in NO.
Dormitory
Dirty roomYES📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
getline. Dùng một mảng cnt[26]: chữ cái của câu 1 cộng, của câu 2 trừ, bỏ qua mọi ký tự không phải chữ cái (cả khoảng trắng lẫn '\r'); cuối cùng mọi ô bằng 0 thì YES. Không cần so độ dài trước, vì khoảng trắng không được tính. Mẫu: “dormitory” và “dirtyroom” cùng gồm d, o×2, r×2, m, i, t, y.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int cnt[26];

int main(){
    string a, b;
    getline(cin, a);
    getline(cin, b);
    for(char c : a) if(isalpha((unsigned char)c)) cnt[tolower(c) - 'a']++;
    for(char c : b) if(isalpha((unsigned char)c)) cnt[tolower(c) - 'a']--;
    for(int k = 0; k < 26; k++)
        if(cnt[k] != 0){ cout << "NO"; return 0; }
    cout << "YES";
    return 0;
}
from collections import Counter
def dem(s):
return Counter(c for c in s.lower() if c.isalpha())
a = input()
b = input()
print("YES" if dem(a) == dem(b) else "NO")Nhà trường cấp email cho $n$ học sinh ($n \le 10^4$) theo thứ tự trong danh sách. Mỗi họ tên nằm trên một dòng (có thể thừa khoảng trắng, hoa thường lộn xộn, ít nhất hai từ). Phần tên email gồm tên (từ cuối) viết thường, nối với chữ cái đầu của các từ họ đệm viết thường theo đúng thứ tự. Nếu phần tên này đã được cấp trước đó thì thêm số thứ tự lần xuất hiện (lần thứ hai thêm 2, lần thứ ba thêm 3…). In email của từng học sinh, đuôi là @truong.edu.vn.
4
nguyen van an
  Nguyen   Van  AN
tran thi  bich ngoc
le anannv@truong.edu.vn
annv2@truong.edu.vn
ngocttb@truong.edu.vn
anl@truong.edu.vn📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
getline ngay sau cin >> n (phần 1). Mỗi dòng tách từ, đưa về chữ thường, ghép tên với chữ đầu các từ còn lại. Dùng map<string, int> đếm số lần mỗi phần tên đã xuất hiện: lần đầu in nguyên, từ lần hai in kèm số đếm. Phần tên chỉ gồm chữ cái nên “annv2” không bao giờ trùng với phần tên của ai khác. Mẫu: hai bạn Nguyen Van An cùng ra “annv”, bạn sau thành “annv2”.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    int n;
    cin >> n;
    string line, w;
    getline(cin, line);                         // bỏ phần còn lại của dòng chứa n
    map<string, int> dem;
    for(int t = 0; t < n; t++){
        getline(cin, line);
        stringstream ss(line);
        vector<string> v;
        while(ss >> w){
            for(char &c : w) c = tolower(c);
            v.push_back(w);
        }
        string e = v.back();                    // tên
        for(int i = 0; i + 1 < (int)v.size(); i++) e += v[i][0];   // chữ đầu họ đệm
        int k = ++dem[e];
        cout << e;
        if(k > 1) cout << k;
        cout << "@truong.edu.vn\n";
    }
    return 0;
}
import sys
lines = sys.stdin.read().split('\n')
n = int(lines[0])
dem = {}
out = []
for t in range(1, n + 1):
v = lines[t].lower().split()
e = v[-1] + ''.join(w[0] for w in v[:-1]) # tên + chữ đầu họ đệm
dem[e] = dem.get(e, 0) + 1
out.append(e + (str(dem[e]) if dem[e] > 1 else '') + '@truong.edu.vn')
print('\n'.join(out))Cho xâu $s$ gồm chữ cái thường, độ dài không quá $10^6$. Tìm nhóm dài nhất các ký tự giống nhau đứng liền nhau. In ký tự của nhóm đó và độ dài nhóm; nếu có nhiều nhóm cùng dài nhất, in nhóm xuất hiện đầu tiên.
aabbbbcddddded 5📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
i ở đầu nhóm, j chạy tới hết nhóm, độ dài nhóm là j - i. Chỉ cập nhật khi dài hơn hẳn để giữ nhóm đầu tiên. Mẫu có các nhóm aa, bbbb, c, ddddd, e; dài nhất là ddddd.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string s;
    cin >> s;
    int n = s.size(), i = 0, bestLen = 0;
    char bestC = s[0];
    while(i < n){
        int j = i;
        while(j < n && s[j] == s[i]) j++;      // nhóm s[i..j-1]
        if(j - i > bestLen){ bestLen = j - i; bestC = s[i]; }
        i = j;
    }
    cout << bestC << " " << bestLen;
    return 0;
}
s = input().strip()
n, i = len(s), 0
best_len, best_c = 0, s[0]
while i < n:
j = i
while j < n and s[j] == s[i]: # nhóm s[i..j-1]
j += 1
if j - i > best_len:
best_len, best_c = j - i, s[i]
i = j
print(best_c, best_len)Cho $n$ số nguyên ($1 \le n \le 10^4$), mỗi số có không quá 1000 chữ số, có thể âm (có dấu - ở đầu), không có số 0 thừa ở đầu và không có -0. In các số theo thứ tự tăng dần, mỗi số một dòng.
6
123 -45 0 -1000 99999999999999999999 -44-1000
-45
-44
0
123
99999999999999999999📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
functools.cmp_to_key; đừng đổi sang int vì số có thể dài, còn chậm.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

bool nhoHonKhongAm(const string &a, const string &b){   // a, b không âm, dạng chuẩn
    if(a.size() != b.size()) return a.size() < b.size();
    return a < b;
}

bool cmp(const string &a, const string &b){
    bool amA = a[0] == '-', amB = b[0] == '-';
    if(amA != amB) return amA;                          // số âm đứng trước
    if(!amA) return nhoHonKhongAm(a, b);
    return nhoHonKhongAm(b.substr(1), a.substr(1));     // cả hai âm: trị tuyệt đối lớn hơn thì nhỏ hơn
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    vector<string> v(n);
    for(auto &x : v) cin >> x;
    sort(v.begin(), v.end(), cmp);
    for(auto &x : v) cout << x << "\n";
    return 0;
}
import sys
from functools import cmp_to_key
def so_khong_am(a, b): # -1, 0, 1 cho hai số không âm dạng chuẩn
if len(a) != len(b):
return -1 if len(a) < len(b) else 1
return (a > b) - (a < b)
def cmp(a, b):
am_a, am_b = a[0] == '-', b[0] == '-'
if am_a != am_b:
return -1 if am_a else 1 # số âm đứng trước
if not am_a:
return so_khong_am(a, b)
return so_khong_am(b[1:], a[1:]) # cả hai âm: trị tuyệt đối lớn hơn thì nhỏ hơn
data = sys.stdin.read().split()
n = int(data[0])
v = sorted(data[1:n + 1], key=cmp_to_key(cmp))
print('\n'.join(v))Xâu nén $t$ (dài không quá $10^5$) gồm các chữ cái thường, mỗi chữ cái có thể được theo sau bởi một số nguyên dương $c$ ($1 \le c \le 10^9$, không có số 0 ở đầu) là số lần lặp của nó; không có số thì lặp 1 lần. Ví dụ a3bc2 giải nén thành aaabcc. Cho $t$ và số $k$ ($1 \le k \le 10^{18}$). Dòng 1 in độ dài của xâu sau giải nén. Dòng 2 in ký tự thứ $k$ (đánh số từ 1) của xâu đó, nếu xâu không đủ $k$ ký tự thì in KHONG CO.
a3bc2d12x
719
d📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
total là độ dài đã đi qua. Cặp này phủ các vị trí từ total + 1 tới total + c; nếu $k$ nằm trong khoảng đó thì đáp án là $ch$. Mẫu: a phủ vị trí 1..3, b là 4, c phủ 5..6, d phủ 7..18, x là 19. Vậy độ dài là 19 và ký tự thứ 7 là d. Nhớ dùng long long cho $c$, total và $k$.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

int main(){
    string t;
    long long k;
    cin >> t >> k;
    int n = t.size(), i = 0;
    long long total = 0;
    char ans = 0;
    while(i < n){
        char ch = t[i++];
        long long c = 0;
        while(i < n && t[i] >= '0' && t[i] <= '9') c = c * 10 + (t[i++] - '0');
        if(c == 0) c = 1;
        if(ans == 0 && total < k && k <= total + c) ans = ch;   // k thuộc đoạn [total+1, total+c]
        total += c;
    }
    cout << total << "\n";
    if(ans) cout << ans;
    else cout << "KHONG CO";
    return 0;
}
import sys
data = sys.stdin.read().split()
t, k = data[0], int(data[1])
n, i = len(t), 0
total, ans = 0, None
while i < n:
ch = t[i]; i += 1
j = i
while j < n and t[j].isdigit():
j += 1
c = int(t[i:j]) if j > i else 1 # số lần lặp (tối đa 10 chữ số)
i = j
if ans is None and total < k <= total + c:
ans = ch
total += c
print(total)
print(ans if ans else 'KHONG CO')
- Không biết học gì trước, học gì sau, học lan man nên kiến thức bị hổng.
- Bí bài không ai gỡ, ngồi cả buổi vẫn không ra rồi bỏ cuộc.
- Code chạy được nhưng không đủ điểm, không biết sai ở đâu, chậm ở đâu.
- Không có đề thi thử và người chấm, nên không biết mình đang ở mức nào.
- Dễ nản giữa chừng khi không có ai theo sát.
- Lộ trình 111 buổi video sắp sẵn từ dòng code đầu tiên đến đề HSG thật của các tỉnh.
- Thầy trực tiếp gỡ bí, chữa bài cho từng em qua nhóm Zalo riêng.
- Hệ thống chấm bài tự động 24/7 và thi thử HSG hằng tuần để biết chính xác mình đang ở đâu.
- Đóng học phí một lần, thầy kèm lâu dài: từ thi chuyên Tin đến HSG quốc gia và cả khi lên đại học.
Nhận xét
Đăng nhận xét