
Bài 46: Hash nâng cao và mảng hậu tố (Suffix Array) trong C++ và Python: chống anti-hash, hash tập hợp, hash cây, thuật toán Kasai
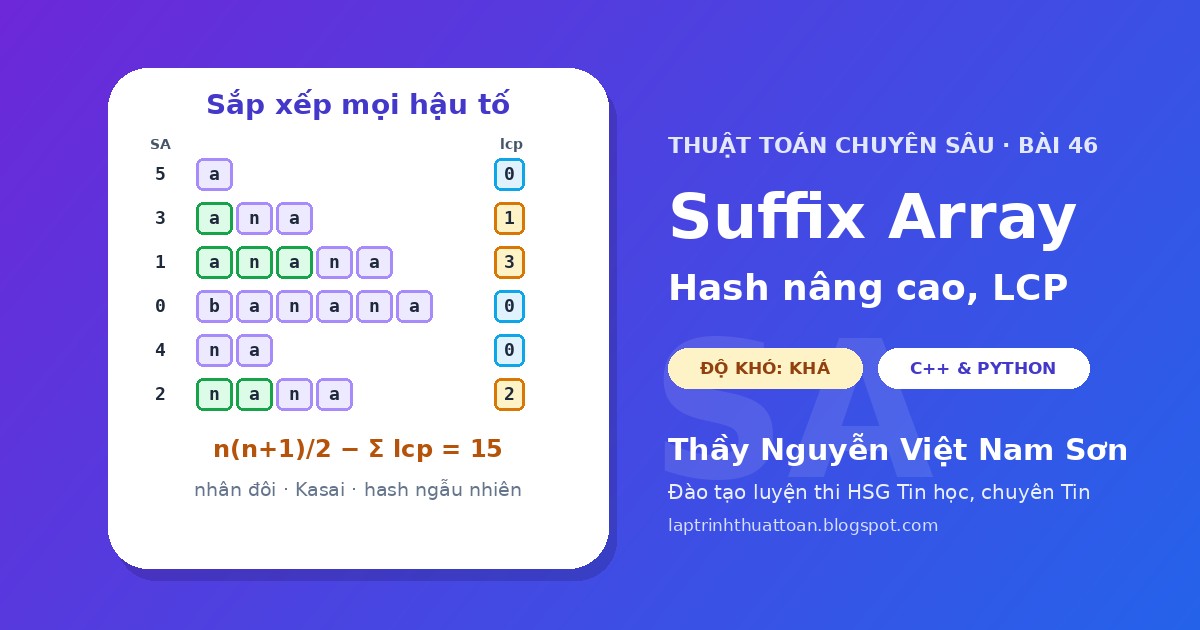
Lời mở đầu
Ở bài này của series Thuật toán chuyên sâu, mình dành trọn cho chủ đề mà đề HSG quốc gia rất thích: xâu. Ở bài 28 em đã có hash đa thức và KMP, ở bài 39 có thêm Z-function, Manacher và Trie. Những công cụ ấy trả lời rất tốt câu hỏi “hai xâu con có bằng nhau không”, “mẫu xuất hiện ở đâu”. Nhưng khi đề hỏi xâu nào nhỏ hơn theo thứ tự từ điển, đếm tất cả xâu con khác nhau, hay hỏi “hai đoạn của dãy số có phải hoán vị của nhau”, “hai cây có cùng hình dạng” thì ta cần thêm vũ khí.
Bài này đi theo hai hướng. Hướng thứ nhất là hash nâng cao: chọn cơ số ngẫu nhiên để không ai “bẫy” được, kết hợp hash với chặt nhị phân để so sánh thứ tự từ điển, và hash cho những đối tượng không phải xâu như tập hợp, đa tập, cây có gốc (nối tiếp bài 33). Hướng thứ hai là mảng hậu tố (Suffix Array) cùng mảng LCP: một cấu trúc dữ liệu “sắp xếp sẵn” mọi hậu tố, giải gọn hàng loạt bài đếm xâu con mà hash phải vất vả chặt nhị phân. Em nên nắm chắc sắp xếp và mảng đếm phân phối trước khi vào phần 3.
Lộ trình bài viết, bấm vào từng phần để nhảy tới:
Phần 1Hash nâng cao: chống anti-hash và so sánh thứ tự từ điển
Nhắc lại nhanh. Ở bài 28, hash tiền tố $h_{i+1} = (h_i \cdot B + s_i) \bmod M$ và mảng lũy thừa $p_i = B^i \bmod M$ cho phép lấy hash xâu con $s[l..l+len-1]$ trong $O(1)$: $\text{get}(l, len) = (h_{l+len} - h_l \cdot p_{len}) \bmod M$. Hai xâu bằng nhau thì hash bằng nhau; hash bằng nhau thì “gần như chắc chắn” xâu bằng nhau. Câu hỏi của phần này: chữ “gần như” ấy đến từ đâu, và khi nào nó sụp đổ?
Vì sao hash có thể bị “hack”? Xét hai xâu khác nhau $x$, $y$ cùng độ dài $L$. Hiệu hash của chúng là
$\text{hash}(x) - \text{hash}(y) = \sum_{k=0}^{L-1} (x_k - y_k) \cdot B^{L-1-k} \pmod M$
đây là một đa thức bậc nhỏ hơn $L$ theo biến $B$, khác đa thức 0. Theo định lý cơ bản của đại số (trên trường số dư modulo số nguyên tố $M$), đa thức ấy có không quá $L - 1$ nghiệm. Vậy nếu $B$ được chọn ngẫu nhiên sau khi dữ liệu đã cố định, xác suất va chạm của một lần so sánh không quá $\frac{L - 1}{M}$. Điểm mấu chốt nằm ở chữ “ngẫu nhiên sau khi”: nếu $B$ và $M$ viết cứng trong code, người ra đề (hoặc người “hack” bài em trên Codeforces) biết trước đa thức của em và hoàn toàn có thể dựng sẵn hai xâu va chạm. Đó gọi là anti-hash test.
| Cách hash | Bị phá thế nào | Đánh giá |
|---|---|---|
$B$ cố định, tràn số unsigned long long ($M = 2^{64}$) | Xâu Thue–Morse độ dài vài nghìn va chạm với mọi $B$ lẻ | không bao giờ dùng |
| $B$ cố định, $M = 10^9 + 7$ | Sinh ngẫu nhiên khoảng $\sqrt{M} \approx 3 \cdot 10^4$ xâu là có hai xâu trùng hash (nghịch lý ngày sinh) | dễ bị hack |
| $B$ ngẫu nhiên, một modulo $M \approx 10^9$ | Mỗi lần so sai với xác suất $\le L / M$; $10^6$ lần so với $L = 10^5$ thì gần như chắc chắn có lần sai | chỉ dùng khi ít phép so |
| $B_1$, $B_2$ ngẫu nhiên, hai modulo $10^9 + 7$ và $998244353$ | Xác suất sai mỗi lần cỡ $(L / M)^2$ | an toàn, chậm gấp đôi |
| $B$ ngẫu nhiên, $M = 2^{61} - 1$ | Mỗi lần sai $\le L / 2^{61} \approx 4 \cdot 10^{-14}$ với $L = 10^5$ | khuyên dùng |
Bảng 1. Các cách chọn tham số hash. Chỉ khi cơ số được sinh ngẫu nhiên lúc chạy thì đánh giá xác suất ở trên mới đúng với mọi dữ liệu vào.
mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
const ull MOD = (1ULL << 61) - 1;
ull B = rng() % (MOD - 1000) + 500;   // cơ số ngẫu nhiên mỗi lần chạy
// h[i + 1] = (mulmod(h[i], B) + s[i]) % MOD; pw[i + 1] = mulmod(pw[i], B);B = random.randrange(500, M - 500) (module random của Python tự lấy hạt giống ngẫu nhiên từ hệ điều hành). Nhớ dùng chung một $B$ cho mọi xâu cần so sánh với nhau.So sánh thứ tự từ điển hai xâu con. Hash chỉ trả lời “bằng hay khác”, nhưng nhiều bài cần biết xâu nào nhỏ hơn. Cách làm: tìm LCP (longest common prefix, độ dài tiền tố chung dài nhất) của hai xâu, rồi so ký tự ngay sau phần chung. Nếu một xâu hết trước thì xâu ngắn hơn (là tiền tố của xâu kia) đứng trước.
Tìm LCP bằng chặt nhị phân: nếu $len$ ký tự đầu trùng nhau thì $len - 1$ ký tự đầu cũng trùng, tính chất “đúng tới một ngưỡng rồi sai mãi” quen thuộc. Mỗi bước chặt chỉ cần so hai hash $O(1)$, nên so sánh hai xâu con tốn $O(\log n)$ thay vì $O(n)$.
| [lo, hi] | mid | mid ký tự đầu | hash |
|---|---|---|---|
| [0, 4] | 2 | ab và ab | bằng → lo = 2 |
| [2, 4] | 3 | abr và abr | bằng → lo = 3 |
| [3, 4] | 4 | abra và abra | bằng → lo = 4 |
Bảng 2. So sánh hai hậu tố của abracadabra: s[0..] = abracadabra và s[7..] = abra. LCP = 4 bằng đúng độ dài xâu ngắn hơn, nên abra < abracadabra. Còn với s[0..] và s[3..] = acadabra thì LCP = 1, so tiếp “b” với “c” được s[0..] < s[3..].
Em thử với các vị trí khác trong mô phỏng: mỗi bước, đoạn vàng là phần đang thử bằng hash; bằng nhau thì cả đoạn chuyển xanh lá và ta tìm tiếp ở nửa trên, khác nhau thì hạ $hi$. Để ý số lần so hash chỉ cỡ $\log_2$ độ dài:
Xem code C++ / Python: so sánh thứ tự từ điển hai xâu con bằng hash + chặt nhị phân lcp (bấm để mở)
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;

const ull MOD = (1ULL << 61) - 1;
ull mulmod(ull a, ull b){                       // a * b mod (2^61 - 1)
    __uint128_t c = (__uint128_t)a * b;
    ull r = (ull)(c & MOD) + (ull)(c >> 61);    // vì 2^61 ≡ 1 (mod M)
    r = (r & MOD) + (r >> 61);
    return r >= MOD ? r - MOD : r;
}

string s;
vector<ull> h, pw;

ull get(int l, int len){                        // hash của s[l..l+len-1]
    return (h[l + len] + MOD - mulmod(h[l], pw[len])) % MOD;
}

int lcp(int a, int b, int maxLen){              // chặt nhị phân độ dài tiền tố chung
    int lo = 0, hi = maxLen;
    while(lo < hi){
        int mid = (lo + hi + 1) / 2;
        if(get(a, mid) == get(b, mid)) lo = mid;
        else hi = mid - 1;
    }
    return lo;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
    ull B = rng() % (MOD - 1000) + 500;         // cơ số NGẪU NHIÊN: chống anti-hash
    cin >> s;
    int n = s.size();
    h.assign(n + 1, 0); pw.assign(n + 1, 1);
    for(int i = 0; i < n; i++){
        h[i + 1] = (mulmod(h[i], B) + (unsigned char)s[i]) % MOD;
        pw[i + 1] = mulmod(pw[i], B);
    }
    int q;
    cin >> q;
    while(q--){
        int l1, r1, l2, r2;
        cin >> l1 >> r1 >> l2 >> r2;
        l1--; l2--;                             // đổi sang đánh số từ 0
        int len1 = r1 - l1, len2 = r2 - l2;
        int L = lcp(l1, l2, min(len1, len2));
        char res;
        if(L == min(len1, len2))                // xâu ngắn hơn là tiền tố của xâu kia
            res = len1 < len2 ? '<' : (len1 > len2 ? '>' : '=');
        else res = s[l1 + L] < s[l2 + L] ? '<' : '>';
        cout << res << '\n';
    }
    return 0;
}
import sys, random
def main():
data = sys.stdin.buffer.read().split()
s = data[0]
n = len(s)
M = (1 << 61) - 1
B = random.randrange(500, M - 500) # cơ số NGẪU NHIÊN: chống anti-hash
h = [0] * (n + 1); pw = [1] * (n + 1)
for i in range(n):
h[i + 1] = (h[i] * B + s[i]) % M
pw[i + 1] = pw[i] * B % M
def get(l, ln): # hash của s[l..l+ln-1]
return (h[l + ln] - h[l] * pw[ln]) % M
def lcp(a, b, max_len): # chặt nhị phân độ dài tiền tố chung
lo, hi = 0, max_len
while lo < hi:
mid = (lo + hi + 1) // 2
if get(a, mid) == get(b, mid):
lo = mid
else:
hi = mid - 1
return lo
q = int(data[1])
out = []
for k in range(q):
l1, r1, l2, r2 = map(int, data[2 + 4 * k: 6 + 4 * k])
l1 -= 1; l2 -= 1
len1, len2 = r1 - l1, r2 - l2
L = lcp(l1, l2, min(len1, len2))
if L == min(len1, len2): # xâu ngắn hơn là tiền tố của xâu kia
out.append('<' if len1 < len2 else ('>' if len1 > len2 else '='))
else:
out.append('<' if s[l1 + L] < s[l2 + L] else '>')
print('\n'.join(out))
main()sort: ví dụ sắp xếp $n$ hậu tố bằng sort(sa.begin(), sa.end(), cmp) với cmp(a, b) = “LCP rồi so ký tự kế tiếp” được mảng hậu tố trong $O(n \log^2 n)$, chỉ cần thuộc hash. Bài tập 3 dùng đúng ý này để tìm xoay vòng nhỏ nhất. Phần 3 sẽ dạy cách xây mảng hậu tố chính xác tuyệt đối, không phụ thuộc xác suất.Phần 2Hash cho tập hợp, đa tập và cây
Bài toán. Cho dãy $a_1, \ldots, a_n$ và $q$ truy vấn, mỗi truy vấn hỏi đoạn $[l_1, r_1]$ có phải là hoán vị của đoạn $[l_2, r_2]$ không, tức là hai đoạn có cùng các giá trị với cùng số lần xuất hiện (cùng đa tập). Sắp xếp từng đoạn rồi so tốn $O(len \log len)$ mỗi truy vấn, quá chậm khi $n, q = 2 \cdot 10^5$.
Ta cần một hàm hash không phụ thuộc thứ tự các phần tử, và tốt nhất là cộng được để dùng mảng cộng dồn như bài 13. Ý tưởng đầu tiên: hash = tổng các phần tử. Nhưng $\{1, 4\}$ và $\{2, 3\}$ cùng tổng 5. Thêm tổng bình phương? $\{1, 5, 6\}$ và $\{2, 3, 7\}$ có cùng tổng (12) và cùng tổng bình phương (62). Mọi công thức “cố định” đều có phản ví dụ, và người ra đề sẽ tìm được.
Lời giải: gán cho mỗi giá trị $v$ một số ngẫu nhiên 64 bit $R(v)$, rồi định nghĩa
$H(\text{đa tập}) = \sum R(v) \bmod 2^{64}$ (mỗi lần xuất hiện cộng một lần)
Hai đa tập khác nhau chỉ có cùng $H$ khi một tổ hợp của các số ngẫu nhiên tình cờ bằng 0, xác suất cỡ $2^{-64}$ (hệ số nhỏ hơn $2^{18}$ thì vẫn dưới $2^{-46}$). Cộng tràn unsigned long long chính là cộng modulo $2^{64}$, không cần làm gì thêm. Và vì là tổng, ta có cộng dồn: $H(a[l..r]) = P_r - P_{l-1}$ với $P_i = R(a_1) + \cdots + R(a_i)$.
| Đoạn | Giá trị | Tổng | Tổng bình phương | Hash $\sum R(v)$ |
|---|---|---|---|---|
| A | 1 5 6 | 12 | 62 | $R(1) + R(5) + R(6)$ |
| B | 2 3 7 | 12 | 62 | $R(2) + R(3) + R(7)$ |
| C | 6 1 5 | 12 | 62 | $R(6) + R(1) + R(5)$ |
Bảng 3. Tổng và tổng bình phương không phân biệt được A với B. Hash bằng số ngẫu nhiên cho A = C (cùng đa tập, khác thứ tự) nhưng A ≠ B với xác suất gần như tuyệt đối.
Xem code C++ / Python: kiểm tra hai đoạn là hoán vị của nhau bằng hash đa tập (bấm để mở)
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
    int n, q;
    cin >> n >> q;
    vector<long long> a(n);
    for(auto &x : a) cin >> x;
    map<long long, ull> R;                      // mỗi giá trị một số ngẫu nhiên 64 bit
    vector<ull> P(n + 1, 0);
    for(int i = 0; i < n; i++){
        if(!R.count(a[i])) R[a[i]] = rng();
        P[i + 1] = P[i] + R[a[i]];              // cộng tràn số = cộng modulo 2^64
    }
    while(q--){
        int l1, r1, l2, r2;
        cin >> l1 >> r1 >> l2 >> r2;
        bool ok = (r1 - l1 == r2 - l2) && (P[r1] - P[l1 - 1] == P[r2] - P[l2 - 1]);
        cout << (ok ? "YES" : "NO") << '\n';
    }
    return 0;
}
import sys, random
def main():
data = sys.stdin.buffer.read().split()
n, q = int(data[0]), int(data[1])
a = data[2:2 + n]
R = {} # mỗi giá trị một số ngẫu nhiên 64 bit
P = [0] * (n + 1)
for i, x in enumerate(a):
if x not in R:
R[x] = random.getrandbits(64)
P[i + 1] = P[i] + R[x]
out = []
pos = 2 + n
for _ in range(q):
l1, r1, l2, r2 = map(int, data[pos:pos + 4]); pos += 4
ok = r1 - l1 == r2 - l2 and P[r1] - P[l1 - 1] == P[r2] - P[l2 - 1]
out.append('YES' if ok else 'NO')
print('\n'.join(out))
main()Biến thể XOR. Thay phép cộng bằng XOR: $H = R(v_1) \oplus R(v_2) \oplus \cdots$. Vì $x \oplus x = 0$, mỗi giá trị xuất hiện chẵn lần sẽ tự triệt tiêu, nên $H$ chỉ “nhớ” tập các giá trị xuất hiện lẻ lần. Điều này cực kỳ tiện cho bài “đếm đoạn con mà mọi giá trị xuất hiện chẵn lần”: đoạn $[l, r]$ thoả khi và chỉ khi XOR tiền tố $X_r = X_{l-1}$, quy về đếm cặp bằng nhau như bài 20 (bài tập 4).
Hash tập hợp (bỏ qua số lần lặp) cũng làm được: chỉ cộng $R(v)$ cho lần xuất hiện đầu tiên của mỗi giá trị. Cả ba kiểu hash này đều có chung một bí quyết: số ngẫu nhiên sinh lúc chạy, giống cơ số ngẫu nhiên của hash xâu.
dict để gán $R(v)$, đừng tạo mảng $10^9$ phần tử.Hash cây: hai cây có gốc có cùng hình dạng không? Hai cây có gốc gọi là đẳng cấu nếu đổi thứ tự các con ở từng đỉnh (và đánh số lại đỉnh) thì cây này thành cây kia. Ta gán cho mỗi đỉnh $u$ một số id mô tả dạng của cây con gốc $u$, theo đúng tinh thần QHĐ trên cây (tính từ lá lên gốc):
- lấy danh sách id của các con của $u$, sắp xếp lại (để thứ tự các con không còn quan trọng);
- tra danh sách đó trong một
map: nếu đã gặp thì $u$ nhận id cũ, chưa gặp thì cấp id mới.
Hai cây con có cùng id khi và chỉ khi chúng đẳng cấu (chứng minh bằng quy nạp theo chiều cao). Lá luôn có danh sách rỗng nên có id 0. Cách này (thuật toán AHU) chính xác tuyệt đối, tổng độ dài các danh sách là $n - 1$ nên chạy $O(n \log n)$. Cũng có cách hash thuần (chẳng hạn $h(u) = 1 + \sum f(h(c))$ với $f$ là một hàm “trộn bit” ngẫu nhiên) chạy nhanh hơn, nhưng lại phải chấp nhận xác suất sai.
Hình 1. Số trong mỗi đỉnh là id dạng cây con: lá có id 0; đỉnh có đúng một con là lá có id 1 (danh sách [0]); danh sách [0, 1] có id 2; gốc có danh sách [1, 2] nên id 3. Hai gốc cùng id 3 nên hai cây đẳng cấu, dù các con được vẽ theo thứ tự khác nhau.
Xem code C++ / Python: kiểm tra hai cây có gốc đẳng cấu (id chính tắc ahu) (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

map<vector<int>, int> ids;                      // danh sách id con (đã sắp xếp) -> id

int rootId(int n, vector<vector<int>> &g, int root){
    vector<int> par(n + 1, 0), order = {root}, id(n + 1);
    for(int k = 0; k < (int)order.size(); k++){ // BFS lấy thứ tự duyệt
        int u = order[k];
        for(int v : g[u]) if(v != par[u]){ par[v] = u; order.push_back(v); }
    }
    for(int k = n - 1; k >= 0; k--){            // đi ngược: lá trước, gốc sau
        int u = order[k];
        vector<int> ch;
        for(int v : g[u]) if(v != par[u]) ch.push_back(id[v]);
        sort(ch.begin(), ch.end());             // bỏ qua thứ tự các con
        auto it = ids.find(ch);
        if(it == ids.end()) it = ids.insert({ch, (int)ids.size()}).first;
        id[u] = it->second;
    }
    return id[root];
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    vector<vector<int>> g1(n + 1), g2(n + 1);
    for(int i = 0; i < n - 1; i++){ int u, v; cin >> u >> v; g1[u].push_back(v); g1[v].push_back(u); }
    for(int i = 0; i < n - 1; i++){ int u, v; cin >> u >> v; g2[u].push_back(v); g2[v].push_back(u); }
    cout << (rootId(n, g1, 1) == rootId(n, g2, 1) ? "YES" : "NO");
    return 0;
}
import sys
ids = {} # bộ id con (đã sắp xếp) -> id
def root_id(n, g, root):
par = [0] * (n + 1)
order = [root]
for u in order: # BFS lấy thứ tự duyệt
for v in g[u]:
if v != par[u]:
par[v] = u
order.append(v)
idv = [0] * (n + 1)
for u in reversed(order): # lá trước, gốc sau
ch = tuple(sorted(idv[v] for v in g[u] if v != par[u]))
if ch not in ids:
ids[ch] = len(ids)
idv[u] = ids[ch]
return idv[root]
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
g1 = [[] for _ in range(n + 1)]; g2 = [[] for _ in range(n + 1)]
pos = 1
for g in (g1, g2):
for _ in range(n - 1):
u, v = int(data[pos]), int(data[pos + 1]); pos += 2
g[u].append(v); g[v].append(u)
print('YES' if root_id(n, g1, 1) == root_id(n, g2, 1) else 'NO')
main()Phần 3Mảng hậu tố (Suffix Array) bằng kỹ thuật nhân đôi
Định nghĩa. Xâu $s$ độ dài $n$ có $n$ hậu tố $s[i..n-1]$ với $i = 0, 1, \ldots, n - 1$. Mảng hậu tố $SA$ là danh sách các vị trí bắt đầu $i$, xếp theo thứ tự từ điển tăng dần của hậu tố tương ứng. Kèm theo là mảng hạng $rk$ (rank): $rk[i]$ = vị trí của hậu tố $i$ trong $SA$, tức là $rk[SA[p]] = p$.
| p | SA[p] | hậu tố s[SA[p]..] | i | rk[i] |
|---|---|---|---|---|
| 0 | 5 | a | 0 | 3 |
| 1 | 3 | ana | 1 | 2 |
| 2 | 1 | anana | 2 | 5 |
| 3 | 0 | banana | 3 | 1 |
| 4 | 4 | na | 4 | 4 |
| 5 | 2 | nana | 5 | 0 |
Bảng 4. Mảng hậu tố của banana: SA = [5, 3, 1, 0, 4, 2], rk = [3, 2, 5, 1, 4, 0]. Hai cột bên phải đọc theo chỉ số i của xâu.
Cách ngây thơ: sắp xếp $n$ xâu, mỗi phép so tốn tới $O(n)$, tổng $O(n^2 \log n)$. Với hash ở phần 1 ta xuống được $O(n \log^2 n)$. Còn đây là cách chính xác, không cần hash: kỹ thuật nhân đôi (prefix doubling).
Ý tưởng. Giả sử đã biết thứ tự của các hậu tố khi chỉ nhìn $k$ ký tự đầu, ghi bằng hạng $rk_k[i]$ (hai hậu tố có $k$ ký tự đầu giống nhau thì cùng hạng). Muốn so theo $2k$ ký tự đầu: $2k$ ký tự đầu của hậu tố $i$ là $k$ ký tự đầu của hậu tố $i$ nối với $k$ ký tự đầu của hậu tố $i + k$. Vậy thứ tự theo $2k$ ký tự chính là thứ tự theo cặp số
$\big(rk_k[i],\ rk_k[i + k]\big)$ (nếu $i + k \ge n$ thì số thứ hai là $-1$, nhỏ hơn mọi hạng)
Sắp xếp theo cặp rồi đánh số lại (cặp khác cặp đứng trên thì hạng tăng 1) được $rk_{2k}$. Bắt đầu từ $k = 1$ (hạng = ký tự), mỗi vòng nhân đôi $k$; sau tối đa $\lceil \log_2 n \rceil$ vòng, $k \ge n$ nên mọi hạng khác nhau và đó là thứ tự thật. Thường dừng sớm hơn nhiều: ngay khi các hạng đôi một khác nhau.
| i | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| s[i] | b | a | n | a | n | a |
| 1 ký tự | 1 | 0 | 2 | 0 | 2 | 0 |
| cặp (k = 1) | (1, 0) | (0, 2) | (2, 0) | (0, 2) | (2, 0) | (0, -1) |
| 2 ký tự | 2 | 1 | 3 | 1 | 3 | 0 |
| cặp (k = 2) | (2, 3) | (1, 1) | (3, 3) | (1, 0) | (3, -1) | (0, -1) |
| 4 ký tự | 3 | 2 | 5 | 1 | 4 | 0 |
Bảng 5. Các vòng nhân đôi với banana (hạng ban đầu: a = 0, b = 1, n = 2). Sau vòng k = 2 mọi hạng (theo 4 ký tự đầu) đã khác nhau, nên rk = [3, 2, 5, 1, 4, 0] chính là mảng hạng thật.
Mô phỏng dưới đây hiển thị các hậu tố theo thứ tự hiện tại. Phần tô vàng là số ký tự đầu đã được xếp, phần xanh dương là $k$ ký tự “mượn” từ hậu tố $i + k$ qua số hạng thứ hai của cặp. Em thử xâu nhiều ký tự lặp như aaaaaaaa để thấy cần đủ $\log_2 n$ vòng:
Cài đặt đơn giản nhất: mỗi vòng gọi sort với khoá là cặp, $O(n \log n)$ mỗi vòng, tổng $O(n \log^2 n)$, chạy tốt với $n \le 10^5$. Em chạy tay để thấy rõ mảng rk thay đổi sau mỗi vòng:
Tăng tốc lên $O(n \log n)$. Thay sort bằng sắp xếp đếm (đếm phân phối) hai lượt, đúng kiểu sắp xếp theo cơ số: sắp theo số thứ hai trước, rồi sắp ổn định theo số thứ nhất. Có một mẹo khiến lượt thứ nhất miễn phí: thêm vào cuối xâu một ký tự nhỏ hơn mọi ký tự (ký tự mã 0) và coi xâu như vòng tròn. Khi đó nửa sau của hậu tố $i$ là nửa đầu của hậu tố $i + k$, nên nếu duyệt $SA$ (đã xếp theo $k$ ký tự) và lấy $SA[p] - k$, ta được ngay danh sách các hậu tố xếp theo nửa sau. Chỉ còn một lượt đếm phân phối theo nửa đầu, $O(n)$ mỗi vòng.
Xem code C++ / Python: mảng hậu tố $O(n \log n)$ với sắp xếp đếm (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    cin >> s;
    for(int x : suffixArray(s)) cout << x << " ";
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
s = sys.stdin.readline().strip()
print(*suffix_array(s))tmp[i] = (sa[i] - k + n) % n: danh sách đã xếp theo nửa sau; (2) đếm phân phối tmp theo rk (nửa đầu), duyệt ngược để giữ ổn định; (3) đánh số lại: hạng tăng khi cặp $(rk[a], rk[a + k])$ khác cặp của hàng trên. Dừng khi hạng lớn nhất bằng $n - 1$. Cuối cùng bỏ phần tử đầu (hậu tố chỉ gồm ký tự 0).list.sort theo khoá số nguyên $rk[i] \cdot M + rk[i + k]$: về lý thuyết $O(n \log^2 n)$ nhưng phần sắp xếp chạy bằng C nên với $n = 10^5$ vẫn chỉ mất khoảng 1 giây. Đừng viết hàm so sánh tự định nghĩa (cmp_to_key) vì chậm gấp hàng chục lần. Với $n$ cỡ $5 \cdot 10^5$ trở lên thì nên chọn C++.Phần 4Mảng LCP và thuật toán Kasai
Một mình $SA$ chưa đủ mạnh. Đi kèm nó luôn là mảng LCP: $lcp[p]$ = độ dài tiền tố chung dài nhất của hai hậu tố đứng cạnh nhau trong $SA$, là $s[SA[p-1]..]$ và $s[SA[p]..]$ (quy ước $lcp[0] = 0$). Vì các hậu tố đã xếp theo thứ tự từ điển, hai hậu tố càng giống nhau thì càng đứng gần nhau, nên mảng LCP chứa gần như mọi thông tin về các xâu con lặp lại.
| p | SA[p] | hậu tố | lcp[p] |
|---|---|---|---|
| 0 | 5 | a | 0 |
| 1 | 3 | ana | 1 |
| 2 | 1 | anana | 3 |
| 3 | 0 | banana | 0 |
| 4 | 4 | na | 0 |
| 5 | 2 | nana | 2 |
Bảng 6. Mảng LCP của banana: lcp = [0, 1, 3, 0, 0, 2]. Ví dụ ana và anana đứng cạnh nhau, chung 3 ký tự đầu.
Tính trực tiếp từng cặp tốn $O(n^2)$ với xâu kiểu aaaa…a. Thuật toán Kasai tính cả mảng trong $O(n)$ nhờ một nhận xét đẹp. Duyệt các hậu tố theo vị trí trong xâu $i = 0, 1, 2, \ldots$ (không theo thứ tự trong $SA$), gọi $h$ là LCP của hậu tố $i$ với hậu tố đứng ngay trước nó trong $SA$ (hậu tố $j$).
Nhận xét: nếu $h > 0$ thì với hậu tố $i + 1$, giá trị tương ứng ít nhất là $h - 1$. Vì sao? Hậu tố $j$ đứng trước hậu tố $i$ và chung $h$ ký tự đầu. Bỏ ký tự đầu của cả hai: hậu tố $j + 1$ vẫn nhỏ hơn hậu tố $i + 1$ và chung $h - 1$ ký tự đầu. Hậu tố đứng ngay trước $i + 1$ trong $SA$ nằm giữa $j + 1$ và $i + 1$, nên nó cũng chung với $i + 1$ ít nhất $h - 1$ ký tự (mọi hậu tố kẹp giữa hai xâu có chung $h - 1$ ký tự đầu thì cũng có chung chừng ấy ký tự đầu).
Vậy sang $i + 1$ ta không so lại từ đầu mà bắt đầu từ $h - 1$. Biến $h$ không bao giờ vượt $n$, mỗi bước giảm tối đa 1, nên tổng số lần tăng $h$ (cũng là số lần so ký tự khớp) không quá $2n$.
Trong mô phỏng, ô xanh dương là những ký tự ta biết chắc trùng nhờ bước trước mà không cần so; chỉ các ô xanh lá mới thật sự được so. Em thử xâu aaaaaaaa: cách ngây thơ tốn cỡ $n^2 / 2$ lần so, còn Kasai chỉ vài lần:
Xem code C++ / Python: mảng hậu tố và mảng lcp (kasai), mẫu dùng khi đi thi (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    cin >> s;
    vector<int> sa = suffixArray(s), lcp = kasai(s, sa);
    for(int x : sa) cout << x << " ";
    cout << "\n";
    for(int x : lcp) cout << x << " ";
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
s = sys.stdin.readline().strip()
sa = suffix_array(s)
print(*sa)
print(*kasai(s, sa))Phần 5Ứng dụng của mảng hậu tố
1. Đếm số xâu con phân biệt. Mỗi xâu con là tiền tố của một hậu tố. Duyệt các hậu tố theo thứ tự trong $SA$: hậu tố $SA[p]$ có $n - SA[p]$ tiền tố, nhưng $lcp[p]$ tiền tố đầu tiên đã xuất hiện ở hậu tố đứng trước. Vậy số xâu con mới là $n - SA[p] - lcp[p]$, và
$\text{số xâu con phân biệt} = \dfrac{n(n+1)}{2} - \sum_p lcp[p]$
Với banana: $21 - (0 + 1 + 3 + 0 + 0 + 2) = 15$.
2. Xâu con lặp lại dài nhất (xuất hiện ít nhất 2 lần, được chồng nhau) có độ dài $\max lcp[p]$: hai lần xuất hiện của nó là hai hậu tố, và hai hậu tố chung tiền tố dài nhất luôn đứng cạnh nhau trong $SA$. Với banana: $\max = 3$, xâu ana. Ở bài 28 em phải chặt nhị phân + hash; giờ chỉ là một vòng for.
Xem code C++ / Python: đếm xâu con phân biệt và tìm xâu con lặp lại dài nhất (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    cin >> s;
    long long n = s.size();
    vector<int> sa = suffixArray(s), lcp = kasai(s, sa);
    long long distinct = n * (n + 1) / 2;
    int best = 0, pos = 0;
    for(int p = 1; p < n; p++){
        distinct -= lcp[p];                     // bỏ phần trùng với hậu tố đứng trước
        if(lcp[p] > best){ best = lcp[p]; pos = sa[p]; }
    }
    cout << distinct << "\n" << best << "\n";
    if(best > 0) cout << s.substr(pos, best);
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
s = sys.stdin.readline().strip()
n = len(s)
sa = suffix_array(s)
lcp = kasai(s, sa)
distinct = n * (n + 1) // 2 - sum(lcp) # bỏ phần trùng với hậu tố đứng trước
best = max(lcp)
print(distinct)
print(best)
if best > 0:
p = lcp.index(best)
print(s[sa[p]:sa[p] + best])3. Xâu con chung dài nhất của hai xâu $a$, $b$. Nối $u = a$ + # + $b$ với # là ký tự không có trong hai xâu. Dựng $SA$ và LCP của $u$. Một xâu con chung là tiền tố chung của một hậu tố bắt đầu trong $a$ và một hậu tố bắt đầu trong $b$; dài nhất thì hai hậu tố ấy có thể chọn đứng cạnh nhau trong $SA$. Vậy đáp án là $\max lcp[p]$ trên các $p$ mà $SA[p-1]$ và $SA[p]$ thuộc hai xâu khác nhau. Ký tự # đảm bảo phần chung không “tràn” từ $a$ sang $b$. Đây là bài tập 6.
4. Tìm mẫu $P$ bằng chặt nhị phân trên $SA$. Mỗi lần xuất hiện của $P$ là một hậu tố bắt đầu bằng $P$, và các hậu tố này nằm liền một khối trong $SA$ (vì xếp theo thứ tự từ điển). Hai lần chặt nhị phân tìm đầu và cuối khối, mỗi lần so $|P|$ ký tự: $O(|P| \log n)$ mỗi mẫu, số lần xuất hiện là độ dài khối. Khác với KMP (mỗi mẫu tốn $O(n + |P|)$), ở đây xâu $s$ chỉ xử lý một lần, rất lợi khi có nhiều mẫu.
| p | SA[p] | hậu tố | bắt đầu bằng an? |
|---|---|---|---|
| 0 | 5 | a | không |
| 1 | 3 | ana | có |
| 2 | 1 | anana | có |
| 3 | 0 | banana | không |
| 4 | 4 | na | không |
| 5 | 2 | nana | không |
Bảng 7. Các hậu tố bắt đầu bằng an tạo thành khối liền p = 1..2 trong SA, nên an xuất hiện 2 lần (tại vị trí 3, 1).
Xem code C++ / Python: đếm số lần xuất hiện của nhiều mẫu bằng chặt nhị phân trên mảng hậu tố (bấm để mở)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    int q;
    cin >> s >> q;
    vector<int> sa = suffixArray(s);
    int n = s.size();
    while(q--){
        string p;
        cin >> p;
        int m = p.size();
        // so m ký tự đầu của hậu tố sa[i] với p
        auto cmp = [&](int i){ return s.compare(sa[i], m, p); };
        int lo = 0, hi = n;                     // hàng đầu tiên có cmp >= 0
        while(lo < hi){ int mid = (lo + hi) / 2; if(cmp(mid) < 0) lo = mid + 1; else hi = mid; }
        int L = lo;
        hi = n;                                 // hàng đầu tiên có cmp > 0
        while(lo < hi){ int mid = (lo + hi) / 2; if(cmp(mid) <= 0) lo = mid + 1; else hi = mid; }
        cout << lo - L << "\n";
    }
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def main():
data = sys.stdin.read().split()
s, q = data[0], int(data[1])
sa = suffix_array(s)
n = len(s)
out = []
for p in data[2:2 + q]:
m = len(p)
lo, hi = 0, n # hàng đầu tiên có s[sa[i]:sa[i]+m] >= p
while lo < hi:
mid = (lo + hi) // 2
if s[sa[mid]:sa[mid] + m] < p: lo = mid + 1
else: hi = mid
L, hi = lo, n # hàng đầu tiên có s[sa[i]:sa[i]+m] > p
while lo < hi:
mid = (lo + hi) // 2
if s[sa[mid]:sa[mid] + m] <= p: lo = mid + 1
else: hi = mid
out.append(lo - L)
print('\n'.join(map(str, out)))
main()5. Xâu con xuất hiện ít nhất $k$ lần, dài nhất. $k$ lần xuất hiện ứng với $k$ hậu tố liên tiếp trong $SA$, độ dài phần chung là min của $k - 1$ giá trị lcp liên tiếp. Đáp án là giá trị lớn nhất của “min trên cửa sổ trượt độ dài $k - 1$”, tính $O(n)$ bằng hàng đợi đơn điệu (bài 25). Em thử áp dụng vào bài Chuỗi Con Xuất Hiện K Lần trong danh sách luyện tập bên dưới.
| Công cụ | Chuẩn bị | Mạnh nhất ở | Lưu ý |
|---|---|---|---|
| Hash (bài 28, phần 1–2) | $O(n)$ | so sánh xâu con bất kỳ, kết hợp chặt nhị phân, hash tập hợp/cây | có xác suất sai, cần cơ số ngẫu nhiên |
| KMP, Z-function (bài 28, 39) | $O(n + m)$ | tìm một mẫu, chu kỳ, đường viền | mỗi mẫu mới phải chạy lại |
| Manacher (bài 39) | $O(n)$ | mọi xâu con đối xứng | chỉ dành cho đối xứng |
| Trie (bài 39) | $O(\sum |w|)$ | từ điển nhiều từ, tiền tố, XOR | tốn bộ nhớ |
| Mảng hậu tố + LCP | $O(n \log n)$ | đếm/so sánh mọi xâu con, xâu lặp, xâu chung, nhiều mẫu | code dài hơn, cần thuộc khuôn mẫu |
Bảng 8. Chọn công cụ xử lý xâu. Khi đi thi, hash thường là lời giải viết nhanh nhất; mảng hậu tố là lời giải chắc chắn nhất cho các bài “đếm xâu con”.
- Xâu Duy Nhất (Xauduynhat) (Trung bình)
- Chuỗi Con Xuất Hiện K Lần (DTKSUB) (Khá)
- Xâu Đối Xứng (XDXUNG) (HSG12 Lâm Đồng 2025 – Bài 3) (Khá)
- Đếm Xâu Tốt (Khó)
- Palindrome Kép (Khó)
Bài tậpLuyện hash nâng cao và mảng hậu tố
Cho xâu $s$ gồm chữ cái thường ($1 \le |s| \le 2 \cdot 10^5$) và $q$ truy vấn ($q \le 2 \cdot 10^5$). Mỗi truy vấn cho hai vị trí $i$, $j$ (đánh số từ 1). In <, > hoặc = tuỳ theo hậu tố bắt đầu tại $i$ nhỏ hơn, lớn hơn hay bằng hậu tố bắt đầu tại $j$ theo thứ tự từ điển.
Input: dòng 1 là $s$, dòng 2 là $q$, $q$ dòng sau mỗi dòng hai số $i$, $j$.
banana
3
2 4
1 6
3 3>
>
=📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
anana, hậu tố 4 là ana; ana là tiền tố của anana nên nhỏ hơn, đáp án >.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    int q;
    cin >> s >> q;
    int n = s.size();
    vector<int> sa = suffixArray(s), rk(n);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;   // hạng của từng hậu tố
    while(q--){
        int i, j;
        cin >> i >> j;
        i--; j--;
        cout << (rk[i] < rk[j] ? '<' : (rk[i] > rk[j] ? '>' : '=')) << '\n';
    }
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def main():
data = sys.stdin.read().split()
s, q = data[0], int(data[1])
sa = suffix_array(s)
rk = [0] * len(s)
for p, i in enumerate(sa):
rk[i] = p # hạng của từng hậu tố
out = []
for k in range(q):
i, j = int(data[2 + 2 * k]) - 1, int(data[3 + 2 * k]) - 1
out.append('<' if rk[i] < rk[j] else ('>' if rk[i] > rk[j] else '='))
print('\n'.join(out))
main()Cho xâu $s$ gồm chữ cái thường ($|s| \le 2 \cdot 10^5$) và hai số $L \le R$. Đếm số xâu con khác nhau của $s$ có độ dài từ $L$ đến $R$.
Input: dòng 1 là $s$, dòng 2 là $L$ và $R$ ($1 \le L \le R \le |s|$).
banana
2 36📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
banana, độ dài 2: an, ba, na; độ dài 3: ana, ban, nan; tổng 6. Đáp án có thể tới $2 \cdot 10^{10}$ nên dùng long long.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    long long L, R;
    cin >> s >> L >> R;
    int n = s.size();
    vector<int> sa = suffixArray(s), lcp = kasai(s, sa);
    long long ans = 0;
    for(int p = 0; p < n; p++){
        // hậu tố sa[p] góp các tiền tố mới có độ dài lcp[p] + 1 .. n - sa[p]
        long long lo = max<long long>(lcp[p] + 1, L), hi = min<long long>(n - sa[p], R);
        if(hi >= lo) ans += hi - lo + 1;
    }
    cout << ans;
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
data = sys.stdin.read().split()
s, L, R = data[0], int(data[1]), int(data[2])
n = len(s)
sa = suffix_array(s)
lcp = kasai(s, sa)
ans = 0
for p in range(n):
# hậu tố sa[p] góp các tiền tố mới có độ dài lcp[p] + 1 .. n - sa[p]
lo, hi = max(lcp[p] + 1, L), min(n - sa[p], R)
if hi >= lo:
ans += hi - lo + 1
print(ans)Cho xâu $s$ gồm chữ cái thường ($1 \le |s| \le 10^5$). Một phép xoay chuyển ký tự đầu xuống cuối xâu. Trong mọi xâu thu được bằng cách xoay $s$ một số lần (kể cả 0 lần), in ra xâu nhỏ nhất theo thứ tự từ điển.
cabcaabcac📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
cabca là cabca, abcac, bcaca, cacab, acabc; nhỏ nhất là abcac. (Bài này còn giải được bằng mảng hậu tố của $s + s$, hoặc thuật toán Booth $O(n)$.)Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;

const ull MOD = (1ULL << 61) - 1;
ull mulmod(ull a, ull b){
    __uint128_t c = (__uint128_t)a * b;
    ull r = (ull)(c & MOD) + (ull)(c >> 61);
    r = (r & MOD) + (r >> 61);
    return r >= MOD ? r - MOD : r;
}
vector<ull> h, pw;
ull get(int l, int len){ return (h[l + len] + MOD - mulmod(h[l], pw[len])) % MOD; }

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
    ull B = rng() % (MOD - 1000) + 500;
    string s;
    cin >> s;
    int n = s.size();
    string t = s + s;                           // mọi xoay vòng là xâu con độ dài n của t
    h.assign(2 * n + 1, 0); pw.assign(2 * n + 1, 1);
    for(int i = 0; i < 2 * n; i++){
        h[i + 1] = (mulmod(h[i], B) + (unsigned char)t[i]) % MOD;
        pw[i + 1] = mulmod(pw[i], B);
    }
    int best = 0;
    for(int i = 1; i < n; i++){
        int lo = 0, hi = n;                     // LCP của t[i..] và t[best..], tối đa n
        while(lo < hi){
            int mid = (lo + hi + 1) / 2;
            if(get(i, mid) == get(best, mid)) lo = mid; else hi = mid - 1;
        }
        if(lo < n && t[i + lo] < t[best + lo]) best = i;
    }
    cout << t.substr(best, n);
    return 0;
}
import sys, random
def main():
s = sys.stdin.readline().strip()
n = len(s)
t = (s + s).encode() # mọi xoay vòng là xâu con độ dài n của t
M = (1 << 61) - 1
B = random.randrange(500, M - 500)
h = [0] * (2 * n + 1); pw = [1] * (2 * n + 1)
for i in range(2 * n):
h[i + 1] = (h[i] * B + t[i]) % M
pw[i + 1] = pw[i] * B % M
best = 0
for i in range(1, n):
lo, hi = 0, n # LCP của t[i..] và t[best..], tối đa n
while lo < hi:
mid = (lo + hi + 1) // 2
if (h[i + mid] - h[i] * pw[mid]) % M == (h[best + mid] - h[best] * pw[mid]) % M:
lo = mid
else:
hi = mid - 1
if lo < n and t[i + lo] < t[best + lo]:
best = i
print(t[best:best + n].decode())
main()Cho dãy $n$ số nguyên ($n \le 2 \cdot 10^5$, $|a_i| \le 10^9$). Đếm số đoạn con liên tiếp khác rỗng mà mọi giá trị trong đoạn đều xuất hiện một số chẵn lần.
6
1 2 2 1 3 34📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
map đếm. Bốn đoạn là 2 2, 1 2 2 1, 3 3, 1 2 2 1 3 3.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;
typedef unsigned long long ull;

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    mt19937_64 rng(chrono::steady_clock::now().time_since_epoch().count());
    int n;
    cin >> n;
    map<long long, ull> R;
    vector<ull> P(n + 1, 0);                    // P[i] = XOR các R(a_j) với j <= i
    for(int i = 1; i <= n; i++){
        long long x;
        cin >> x;
        if(!R.count(x)) R[x] = rng();
        P[i] = P[i - 1] ^ R[x];
    }
    sort(P.begin(), P.end());                   // đếm số cặp P bằng nhau
    long long ans = 0;
    for(int i = 0, j; i <= n; i = j){
        for(j = i; j <= n && P[j] == P[i]; j++);
        long long c = j - i;
        ans += c * (c - 1) / 2;
    }
    cout << ans;
    return 0;
}
import sys, random
from collections import Counter
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
R = {}
cnt = Counter()
cur = 0
cnt[0] = 1 # P[0] = 0
for x in data[1:n + 1]:
if x not in R:
R[x] = random.getrandbits(64)
cur ^= R[x]
cnt[cur] += 1
print(sum(c * (c - 1) // 2 for c in cnt.values()))
main()Cho xâu $s$ gồm chữ cái thường ($|s| \le 2 \cdot 10^5$). Đếm số xâu con khác nhau xuất hiện trong $s$ ít nhất hai lần (các lần xuất hiện được phép chồng lên nhau).
banana5📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
banana, lcp = [0, 1, 3, 0, 0, 2] cho $1 + 2 + 2 = 5$: các xâu a, an, ana, n, na.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    cin >> s;
    vector<int> sa = suffixArray(s), lcp = kasai(s, sa);
    long long ans = 0;
    for(int p = 1; p < (int)s.size(); p++)
        ans += max(0, lcp[p] - lcp[p - 1]);     // các độ dài mới lần đầu được lặp lại
    cout << ans;
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
s = sys.stdin.readline().strip()
sa = suffix_array(s)
lcp = kasai(s, sa)
print(sum(max(0, lcp[p] - lcp[p - 1]) for p in range(1, len(s))))Cho hai xâu $a$, $b$ gồm chữ cái thường ($|a|, |b| \le 10^5$), mỗi xâu trên một dòng. Tìm xâu dài nhất xuất hiện liên tiếp trong cả hai xâu. Dòng 1 in độ dài; nếu độ dài lớn hơn 0 thì dòng 2 in xâu đó, có nhiều xâu cùng độ dài thì in xâu nhỏ nhất theo thứ tự từ điển.
xabcdyzbcd
bcdqabcz3
abc📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
# + $b$, xét các cặp hàng kề nhau có một hậu tố thuộc $a$ (bắt đầu trước vị trí $|a|$) và một thuộc $b$. Lấy cặp có lcp lớn nhất; nếu bằng nhau, giữ cặp gặp đầu tiên theo thứ tự $SA$, đó chính là xâu nhỏ nhất. Ví dụ: abc và bcd đều dài 3 và chung cho hai xâu, in abc.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string a, b;
    cin >> a >> b;
    int na = a.size();
    string u = a + "#" + b;                     // '#' không có trong a, b
    vector<int> sa = suffixArray(u), lcp = kasai(u, sa);
    int best = 0, pos = 0;
    for(int p = 1; p < (int)u.size(); p++){
        bool x = sa[p - 1] < na, y = sa[p] < na;   // hậu tố thuộc a hay thuộc b
        if(x != y && lcp[p] > best){ best = lcp[p]; pos = sa[p]; }
    }
    cout << best << "\n";
    if(best > 0) cout << u.substr(pos, best);
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
data = sys.stdin.read().split()
a, b = data[0], data[1]
na = len(a)
u = a + '#' + b # '#' không có trong a, b
sa = suffix_array(u)
lcp = kasai(u, sa)
best, pos = 0, 0
for p in range(1, len(u)):
if (sa[p - 1] < na) != (sa[p] < na) and lcp[p] > best:
best, pos = lcp[p], sa[p]
print(best)
if best > 0:
print(u[pos:pos + best])Cho xâu $s$ gồm chữ cái thường ($|s| \le 2 \cdot 10^5$) và số $k$ ($1 \le k \le 10^{18}$). Xếp mọi xâu con khác nhau của $s$ theo thứ tự từ điển tăng dần. In xâu thứ $k$, hoặc $-1$ nếu không có đủ $k$ xâu.
Input: dòng 1 là $s$, dòng 2 là $k$.
banana
6b📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
banana: a, an, ana, anan, anana, rồi b là xâu thứ 6.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

vector<int> suffixArray(string s){              // O(n log n)
    s.push_back(0);                             // ký tự 0 nhỏ hơn mọi ký tự khác
    int n = s.size(), K = max(256, n);
    vector<int> sa(n), rk(n), tmp(n), cnt(K, 0);
    for(int i = 0; i < n; i++) cnt[(unsigned char)s[i]]++;
    for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
    for(int i = n - 1; i >= 0; i--) sa[--cnt[(unsigned char)s[i]]] = i;
    rk[sa[0]] = 0;
    for(int i = 1; i < n; i++) rk[sa[i]] = rk[sa[i - 1]] + (s[sa[i]] != s[sa[i - 1]]);
    for(int k = 1; k < n && rk[sa[n - 1]] < n - 1; k *= 2){
        for(int i = 0; i < n; i++) tmp[i] = (sa[i] - k + n) % n;   // đã xếp sẵn theo nửa sau
        fill(cnt.begin(), cnt.end(), 0);
        for(int i = 0; i < n; i++) cnt[rk[tmp[i]]]++;              // đếm phân phối theo nửa đầu
        for(int i = 1; i < K; i++) cnt[i] += cnt[i - 1];
        for(int i = n - 1; i >= 0; i--) sa[--cnt[rk[tmp[i]]]] = tmp[i];
        tmp[sa[0]] = 0;                                            // đánh số lại
        for(int i = 1; i < n; i++){
            int a = sa[i - 1], b = sa[i];
            tmp[b] = tmp[a] + (rk[a] != rk[b] || rk[(a + k) % n] != rk[(b + k) % n]);
        }
        rk.swap(tmp);
    }
    sa.erase(sa.begin());                       // bỏ hậu tố chỉ gồm ký tự 0
    return sa;
}

vector<int> kasai(const string &s, const vector<int> &sa){   // lcp[p] = LCP(sa[p-1], sa[p])
    int n = s.size();
    vector<int> rk(n), lcp(n, 0);
    for(int p = 0; p < n; p++) rk[sa[p]] = p;
    int h = 0;
    for(int i = 0; i < n; i++){
        if(rk[i] == 0){ h = 0; continue; }
        int j = sa[rk[i] - 1];                  // hậu tố đứng ngay trước trong SA
        while(i + h < n && j + h < n && s[i + h] == s[j + h]) h++;
        lcp[rk[i]] = h;
        if(h > 0) h--;                          // sang i + 1: giảm tối đa 1
    }
    return lcp;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    string s;
    long long k;
    cin >> s >> k;
    int n = s.size();
    vector<int> sa = suffixArray(s), lcp = kasai(s, sa);
    for(int p = 0; p < n; p++){
        long long fresh = (n - sa[p]) - lcp[p];  // số xâu con mới, đã theo thứ tự tăng
        if(k <= fresh){
            cout << s.substr(sa[p], lcp[p] + k);
            return 0;
        }
        k -= fresh;
    }
    cout << -1;
    return 0;
}
import sys
def suffix_array(s): # nhân đôi, O(n log^2 n) nhưng sort chạy bằng C
n = len(s)
rk = [ord(c) for c in s]
sa = list(range(n))
M = max(n, 256) + 1
k = 1
while n:
key = [rk[i] * M + (rk[i + k] + 1 if i + k < n else 0) for i in range(n)]
sa.sort(key=key.__getitem__)
rk = [0] * n
for t in range(1, n):
rk[sa[t]] = rk[sa[t - 1]] + (key[sa[t]] != key[sa[t - 1]])
if rk[sa[-1]] == n - 1:
break
k *= 2
return sa
def kasai(s, sa): # lcp[p] = LCP(sa[p-1], sa[p])
n = len(s)
rk = [0] * n
for p, i in enumerate(sa):
rk[i] = p
lcp = [0] * n
h = 0
for i in range(n):
if rk[i] == 0:
h = 0
continue
j = sa[rk[i] - 1] # hậu tố đứng ngay trước trong SA
while i + h < n and j + h < n and s[i + h] == s[j + h]:
h += 1
lcp[rk[i]] = h
if h:
h -= 1 # sang i + 1: giảm tối đa 1
return lcp
data = sys.stdin.read().split()
s, k = data[0], int(data[1])
n = len(s)
sa = suffix_array(s)
lcp = kasai(s, sa)
ans = '-1'
for p in range(n):
fresh = (n - sa[p]) - lcp[p] # số xâu con mới, đã theo thứ tự tăng
if k <= fresh:
ans = s[sa[p]:sa[p] + lcp[p] + k]
break
k -= fresh
print(ans)Cho hai cây không gốc, mỗi cây có $n$ đỉnh đánh số từ 1 ($n \le 10^5$). Hỏi có thể đánh số lại các đỉnh của cây thứ hai để được đúng cây thứ nhất không (hai cây đẳng cấu)? In YES hoặc NO.
Input: dòng đầu là $n$; $n - 1$ dòng tiếp theo là các cạnh của cây thứ nhất; $n - 1$ dòng cuối là các cạnh của cây thứ hai.
5
1 2
2 3
3 4
3 5
5 4
4 1
4 3
3 2YES📝 Nộp bài, chấm tự động trên ClueOJ ↗
💡 Gợi ý
YES. Nhớ dùng chung một map id cho cả hai cây, và duyệt BFS thay vì đệ quy vì cây có thể là đường thẳng dài $10^5$. Ví dụ: cả hai cây đều gồm một đỉnh bậc 3 nối với hai lá và một đường dài 2 (đỉnh 3 ở cây thứ nhất, đỉnh 4 ở cây thứ hai); mỗi cây có hai tâm.Xem code tham khảo (C++ / Python)
#include <bits/stdc++.h>
using namespace std;

map<vector<int>, int> ids;                      // danh sách id con (đã sắp xếp) -> id

int rootId(int n, vector<vector<int>> &g, int root){
    vector<int> par(n + 1, 0), order = {root}, id(n + 1);
    for(int k = 0; k < (int)order.size(); k++){ // BFS lấy thứ tự duyệt
        int u = order[k];
        for(int v : g[u]) if(v != par[u]){ par[v] = u; order.push_back(v); }
    }
    for(int k = n - 1; k >= 0; k--){            // đi ngược: lá trước, gốc sau
        int u = order[k];
        vector<int> ch;
        for(int v : g[u]) if(v != par[u]) ch.push_back(id[v]);
        sort(ch.begin(), ch.end());             // bỏ qua thứ tự các con
        auto it = ids.find(ch);
        if(it == ids.end()) it = ids.insert({ch, (int)ids.size()}).first;
        id[u] = it->second;
    }
    return id[root];
}

vector<int> centers(int n, vector<vector<int>> &g){   // bóc lá dần từ ngoài vào
    vector<int> deg(n + 1), leaves;
    for(int u = 1; u <= n; u++){ deg[u] = g[u].size(); if(deg[u] <= 1) leaves.push_back(u); }
    int remain = n;
    while(remain > 2){
        remain -= leaves.size();
        vector<int> nxt;
        for(int u : leaves) for(int v : g[u]) if(--deg[v] == 1) nxt.push_back(v);
        leaves = nxt;
    }
    return leaves;
}

int main(){
    ios::sync_with_stdio(false); cin.tie(nullptr);
    int n;
    cin >> n;
    vector<vector<int>> g1(n + 1), g2(n + 1);
    for(int i = 0; i < n - 1; i++){ int u, v; cin >> u >> v; g1[u].push_back(v); g1[v].push_back(u); }
    for(int i = 0; i < n - 1; i++){ int u, v; cin >> u >> v; g2[u].push_back(v); g2[v].push_back(u); }
    int target = rootId(n, g1, centers(n, g1)[0]);
    bool ok = false;
    for(int c : centers(n, g2)) if(rootId(n, g2, c) == target) ok = true;
    cout << (ok ? "YES" : "NO");
    return 0;
}
import sys
ids = {} # bộ id con (đã sắp xếp) -> id
def root_id(n, g, root):
par = [0] * (n + 1)
order = [root]
for u in order: # BFS lấy thứ tự duyệt
for v in g[u]:
if v != par[u]:
par[v] = u
order.append(v)
idv = [0] * (n + 1)
for u in reversed(order): # lá trước, gốc sau
ch = tuple(sorted(idv[v] for v in g[u] if v != par[u]))
if ch not in ids:
ids[ch] = len(ids)
idv[u] = ids[ch]
return idv[root]
def centers(n, g): # bóc lá dần từ ngoài vào
deg = [len(x) for x in g]
leaves = [u for u in range(1, n + 1) if deg[u] <= 1]
remain = n
while remain > 2:
remain -= len(leaves)
nxt = []
for u in leaves:
for v in g[u]:
deg[v] -= 1
if deg[v] == 1:
nxt.append(v)
leaves = nxt
return leaves
def main():
data = sys.stdin.buffer.read().split()
n = int(data[0])
g1 = [[] for _ in range(n + 1)]; g2 = [[] for _ in range(n + 1)]
pos = 1
for g in (g1, g2):
for _ in range(n - 1):
u, v = int(data[pos]), int(data[pos + 1]); pos += 2
g[u].append(v); g[v].append(u)
target = root_id(n, g1, centers(n, g1)[0])
ok = any(root_id(n, g2, c) == target for c in centers(n, g2))
print('YES' if ok else 'NO')
main()
- Không biết học gì trước, học gì sau, học lan man nên kiến thức bị hổng.
- Bí bài không ai gỡ, ngồi cả buổi vẫn không ra rồi bỏ cuộc.
- Code chạy được nhưng không đủ điểm, không biết sai ở đâu, chậm ở đâu.
- Không có đề thi thử và người chấm, nên không biết mình đang ở mức nào.
- Dễ nản giữa chừng khi không có ai theo sát.
- Lộ trình 111 buổi video sắp sẵn từ dòng code đầu tiên đến đề HSG thật của các tỉnh.
- Thầy trực tiếp gỡ bí, chữa bài cho từng em qua nhóm Zalo riêng.
- Hệ thống chấm bài tự động 24/7 và thi thử HSG hằng tuần để biết chính xác mình đang ở đâu.
- Đóng học phí một lần, thầy kèm lâu dài: từ thi chuyên Tin đến HSG quốc gia và cả khi lên đại học.
Nhận xét
Đăng nhận xét